本記事のポイント
SaaSの行動ログから、HMMで潜在的な利用状態を推定する例です。元実装は事前分布を使ったMAP型の点推定で、パラメータの完全なベイズ事後推定ではありません。本文には200人版と1,000人版の結果が混在するため、人数を各図表で明示します。心理状態の同定、解約予測の精度、介入効果は検証していません。
はじめに
SaaSビジネスにおいて、解約率(チャーンレート)の管理はLTV(顧客生涯価値)を左右する最重要指標のひとつです。多くの企業がログイン頻度や機能利用率、サポート問い合わせ件数といった行動指標をダッシュボードで監視していますが、「数字が下がったことに気づいたときにはすでに手遅れだった」という経験をお持ちの方も少なくないのではないでしょうか。
その背景には、観測できる行動データの裏に「見えない心理状態」が存在するという本質的な課題があります。ログイン頻度が週に3回あったとしても、その顧客が「満足して使い続けている」のか「惰性でログインしているだけ」なのかは、数値だけでは判別できません。
行動ログの時系列をHMMでモデル化し、利用が活発・中間・低調という3つの潜在状態を推定します。Engaged、At-Risk、Disengagedという名称は解釈のためのラベルで、顧客の満足や不満を測定した結果ではありません。
Salesforce Data CloudやSnowflakeにある行動ログも入力にできます。状態推定を解約防止に使う前に、実際の解約との対応と、フォローの効果を検証します。
データ統合の進展とSaaS解約率の課題
データは集まった。でも「次に何をすればいいかわからない」
近年、生成AIの活用を見据えたデータ統合の動きが加速しています。Salesforce Data Cloud、Snowflake、Databricksなどのプラットフォームを導入し、CRMの顧客情報、プロダクトの利用ログ、サポートのチケット情報などを一元管理する企業が増えてきました。
しかし、多くの企業が直面するのが「データは溜まったが、そこから何をすればいいかわからない」という壁です。ダッシュボードでグラフを見ることはできても、「この数字をどう読み取り、どんなアクションにつなげるか」が明確でないまま、データが眠ってしまうケースが少なくありません。
この課題は、SaaSの解約防止でも同じです。解約率は月次で1%改善するだけで年間収益に大きな差が出る重要指標ですが、現在多くの企業が採用している方法には、構造的な限界があります。
従来の「しきい値アラート」方式では限界がある
しきい値ベースとは
「しきい値ベース」とは、特定の数値が基準を超えたらアラートを出す方式のことです。たとえば「ログイン回数が週5回を下回ったら要注意」「サポート問い合わせが月3件を超えたら警告」のように、あらかじめ決めた基準値(しきい値)で判定します。Excelの条件付き書式でセルを赤くするようなイメージです。
この方式の3つの限界
- 気づいたときには手遅れ 「ログイン頻度が50%低下したらアラート」という設定では、低下が起きてからの対応になる。患者が倒れてから救急車を呼ぶようなもの
- 木を見て森を見ず ログイン頻度、機能利用率、サポート件数をバラバラに監視しても、顧客の「全体的な健康状態」はわからない
- 同じ症状でも原因が違う ログインが減った原因が「不満」なのか「繁忙期で多忙」なのかを区別できない
「データを集める」の次のステップへ
HMMは複数の行動指標と時系列をまとめて扱い、利用状態を確率で推定します。ただし、ログインの減少が不満によるものか、多忙によるものかは、このモデルだけでは区別できません。面談やアンケートなどの情報で解釈を確かめる必要があります。
推定した状態は、フォロー対象を選ぶ際の情報として使えます。どの対応が解約を減らすかは、別途検証します。
理論 隠れマルコフモデルとは何か
直感的な理解
隠れマルコフモデル(Hidden Markov Model, HMM)は、「直接は観測できない状態」と「観測できるデータ」の関係を確率的にモデル化する統計手法です。一見難しそうな名前ですが、考え方はシンプルです。
ひとことで言うと
HMMは、直接観測できない状態の遷移と、各状態から観測データが生じる確率分布をモデル化する手法です。ここでは利用ログのパターンを3状態で表します。
日常生活に例えると、天気と体調の関係に似ています。友人の体調(「元気」「だるそう」「体調不良」)を毎日電話で聞くことはできますが、友人の住む街の天気は直接見えません。しかし、「晴れの日は元気な確率が高い」「雨の日はだるそうな確率が高い」という傾向があれば、体調の報告から天気を逆推定できます。
SaaSの解約予測に当てはめると、次のようになります。
隠れ状態(直接は見えない)
- Engaged(積極的利用) 利用指標が高い潜在状態。満足度との対応は別途確認する
- At-Risk(リスク状態) 利用指標が中間的な潜在状態。不満を直接測定したものではない
- Disengaged(離脱傾向) 利用指標が低い潜在状態。解約の発生とは区別する
観測データ(実際に計測できる)
- 週あたりのログイン回数
- 週あたりの主要機能の利用回数
- 週あたりのサポート問い合わせ件数
- 週あたりのセッション滞在時間(分)
HMMは、毎週の複数の行動指標と過去からの推移をもとに潜在状態を推定します。たとえば、設定した遷移行列ではEngagedから翌週At-Riskへ移る確率は12%です。これはモデル上の状態の予測で、不安という感情や解約の発生確率を示すものではありません。
モデルの3つの構成要素
HMMは、以下の3つの要素で定義されます。
1. 状態遷移確率(Transition Probability)
ある隠れ状態から別の隠れ状態に遷移する確率を表します。たとえば「今週Engagedだった顧客が、来週もEngagedである確率は85.0%」「At-Riskに移る確率は12.0%」のように定義されます。この確率は3×3の行列(遷移行列)として表現され、各行の合計が1になります。
2. 出力確率(Emission Probability)
各隠れ状態において、どのような観測データが生成されるかの確率分布です。たとえばEngaged状態のユーザーは「ログイン回数が平均18回」「セッション時間が平均45分」といった特徴を持ちます。本記事では正規分布(ガウス分布)で近似しています。回数や件数は非負の整数なので、実データではポアソン分布や負の二項分布なども候補になります。特に平均が小さい問い合わせ件数では、正規分布による近似が適切かを確認します。
3. 初期状態確率
最初の時点(観測開始時)に顧客がどの状態にいるかの確率分布です。
「ベイズ」を加える意味
HMMには最尤推定、MAP推定、ベイズ推定などの推定法があります。元実装は、遷移確率に事前分布を置いて点推定するMAP型です。状態確率を出せることと、パラメータの事後分布を推定したことは異なります。
具体的には、状態遷移確率にディリクレ分布(Dirichlet Distribution)と呼ばれる事前分布を設定します。ディリクレ分布は「確率の確率分布」であり、「遷移確率はこのあたりの値をとりやすいだろう」という事前知識を表現できます。
ベイズアプローチの利点
- 少量データでの安定性 事前分布が正則化の役割を果たし、データが少ない場合でも極端な推定結果を避けられる
- 不確実性の定量化 パラメータの事後分布を通じて推定の不確実性を表せる。状態確率そのものは、パラメータを点推定するHMMでも計算できる
- ドメイン知識の組込み 「一気にEngagedからDisengagedに移ることは稀だ」といったビジネス知識を事前分布として反映できる
実験 ダミーデータの設計
理論の有効性を検証するため、既知のパラメータでダミーデータ(シミュレーションデータ)を生成し、モデルがそのパラメータを正しく復元できるかを確認しました。実装の動作確認には使えますが、実際の顧客に対する予測精度を保証するものではありません。
データ設計の概要
200人版と1,000人版の2つのシミュレーションがあり、いずれも52週間分の行動ログを生成しています。この節の概要と後段のリスク分類表は200人版で、学習節のデータ件数は1,000人版です。図表が同一実行の結果であるとは扱わないでください。各ユーザーは毎週4つの指標が記録されます。
| 観測変数 | Engaged(平均) | At-Risk(平均) | Disengaged(平均) |
|---|---|---|---|
| ログイン回数/週 | 18.0 | 8.0 | 2.0 |
| 機能利用回数/週 | 12.0 | 5.0 | 1.0 |
| サポート問い合わせ件数/週 | 0.3 | 1.5 | 2.5 |
| セッション時間(分)/週 | 45.0 | 20.0 | 5.0 |
Engaged状態のユーザーは高頻度でログインし、長時間利用しており、サポートへの問い合わせは少ないという直感的に理解しやすいパターンになっています。反対にDisengaged状態のユーザーはほとんどログインせず、サポートへの問い合わせだけが多い(不満を感じている)傾向を示しています。
真の遷移行列
データ生成に使用した状態遷移確率(真の遷移行列)は以下の通りです。
| 遷移元 → 遷移先 | Engaged | At-Risk | Disengaged |
|---|---|---|---|
| Engaged | 0.850 | 0.120 | 0.030 |
| At-Risk | 0.150 | 0.700 | 0.150 |
| Disengaged | 0.050 | 0.180 | 0.770 |
この行列からは、いくつかの重要なビジネス上の意味が読み取れます。Engaged状態は比較的安定しており、85%の確率で翌週も維持されます。一方、At-Risk状態は不安定で、Engagedに回復する確率(15%)とDisengagedに悪化する確率(15%)が拮抗しています。Disengagedに一度陥ると、そこから脱出する確率は比較的低く(Engagedへ5%、At-Riskへ18%)。自己遷移確率はEngagedより低く、吸収状態ではありません。
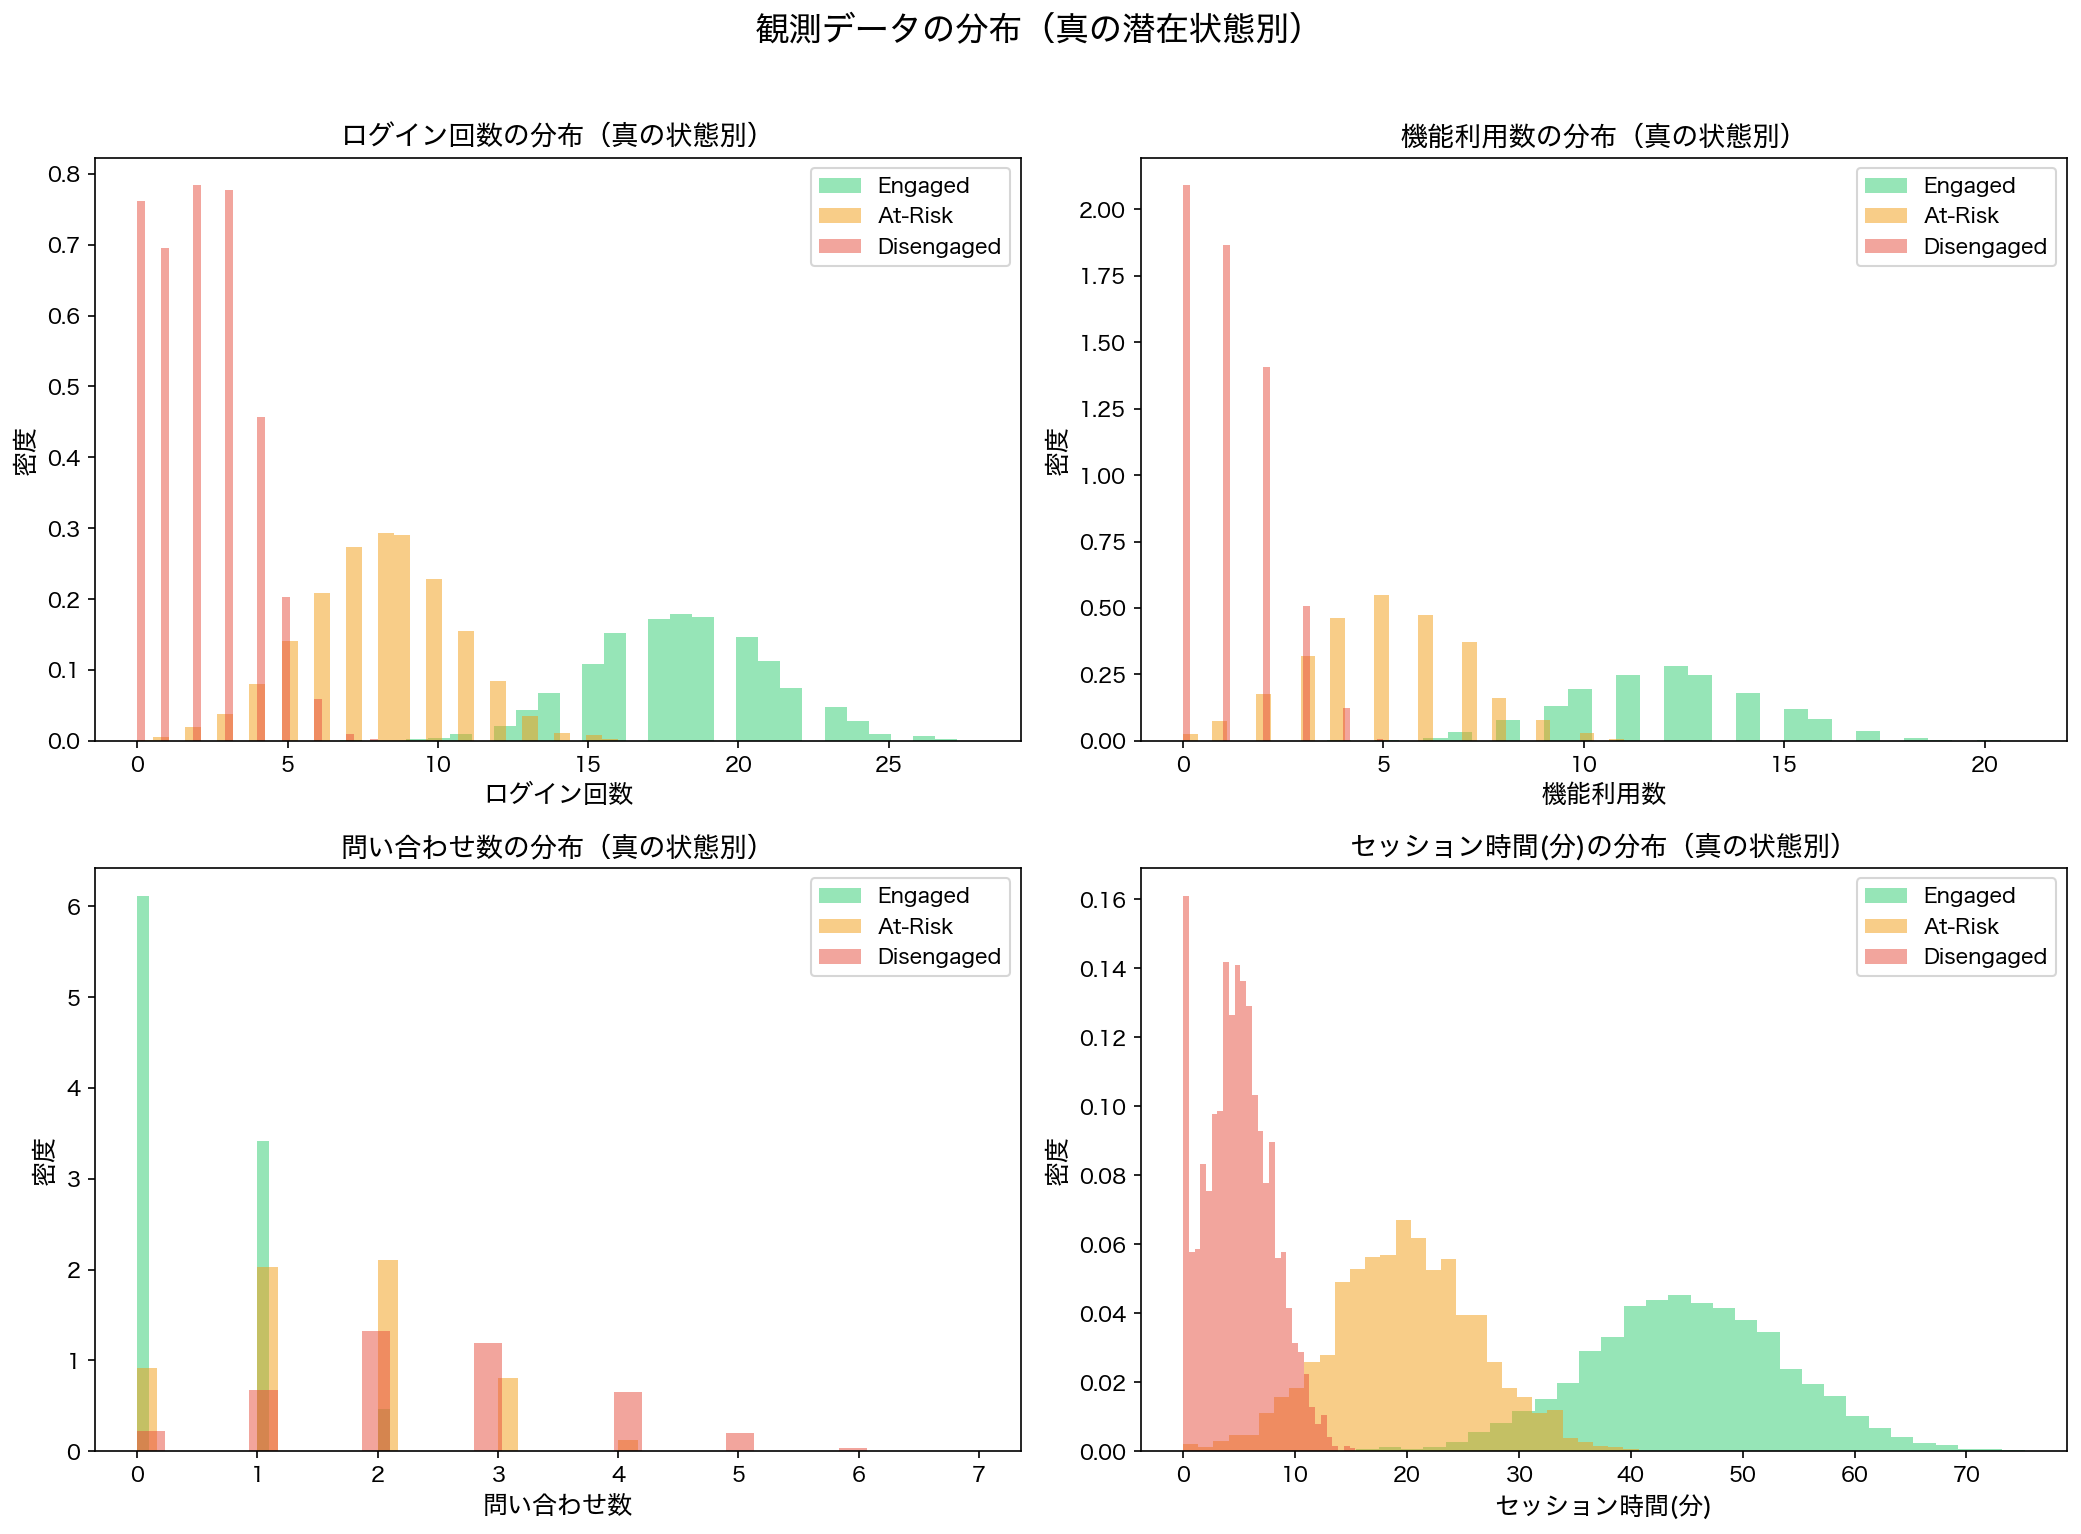
52週間のシミュレーション行動データの概要。4つの観測変数の分布と状態別の特徴。元コードには200人版と1,000人版があり、この図と実行版の対応は未確認
モデルの学習と収束
HMMの学習では、初期値から反復計算でパラメータを更新します。EM法では学習データへの当てはまりを改善しますが、局所解に落ち着くことがあり、真の値への接近や予測精度の向上は保証されません。ベイズ推定の結果と確認するには、事前分布と事後分布の計算法、診断結果の記載も必要です。
今回のシミュレーションでは、1,000ユーザー×52週間=52,000データポイントを入力として、モデルはわずか数回の繰り返しで安定しました。下のグラフは、繰り返しのたびに学習データへの当てはまり(対数尤度)が改善していく様子を示しています。
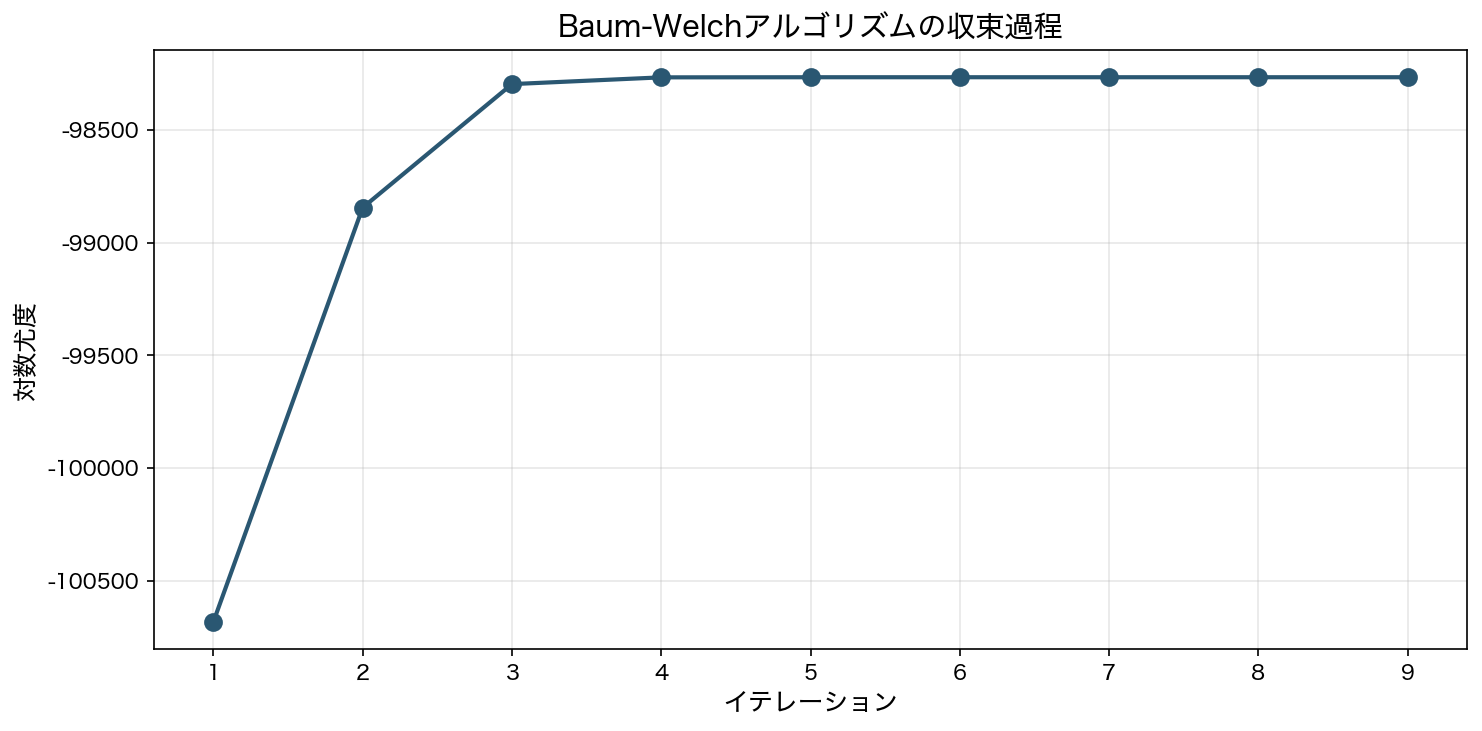
掲載された対数尤度の推移。9回の反復で変化が小さくなったことは、真値への収束や将来予測の精度を保証しない
収束が速い意味
反復回数は初期値、収束判定のしきい値、状態間の分離などに左右されます。複数の初期値での推定や未使用期間での評価を行い、少ない反復で止まった理由を確認します。
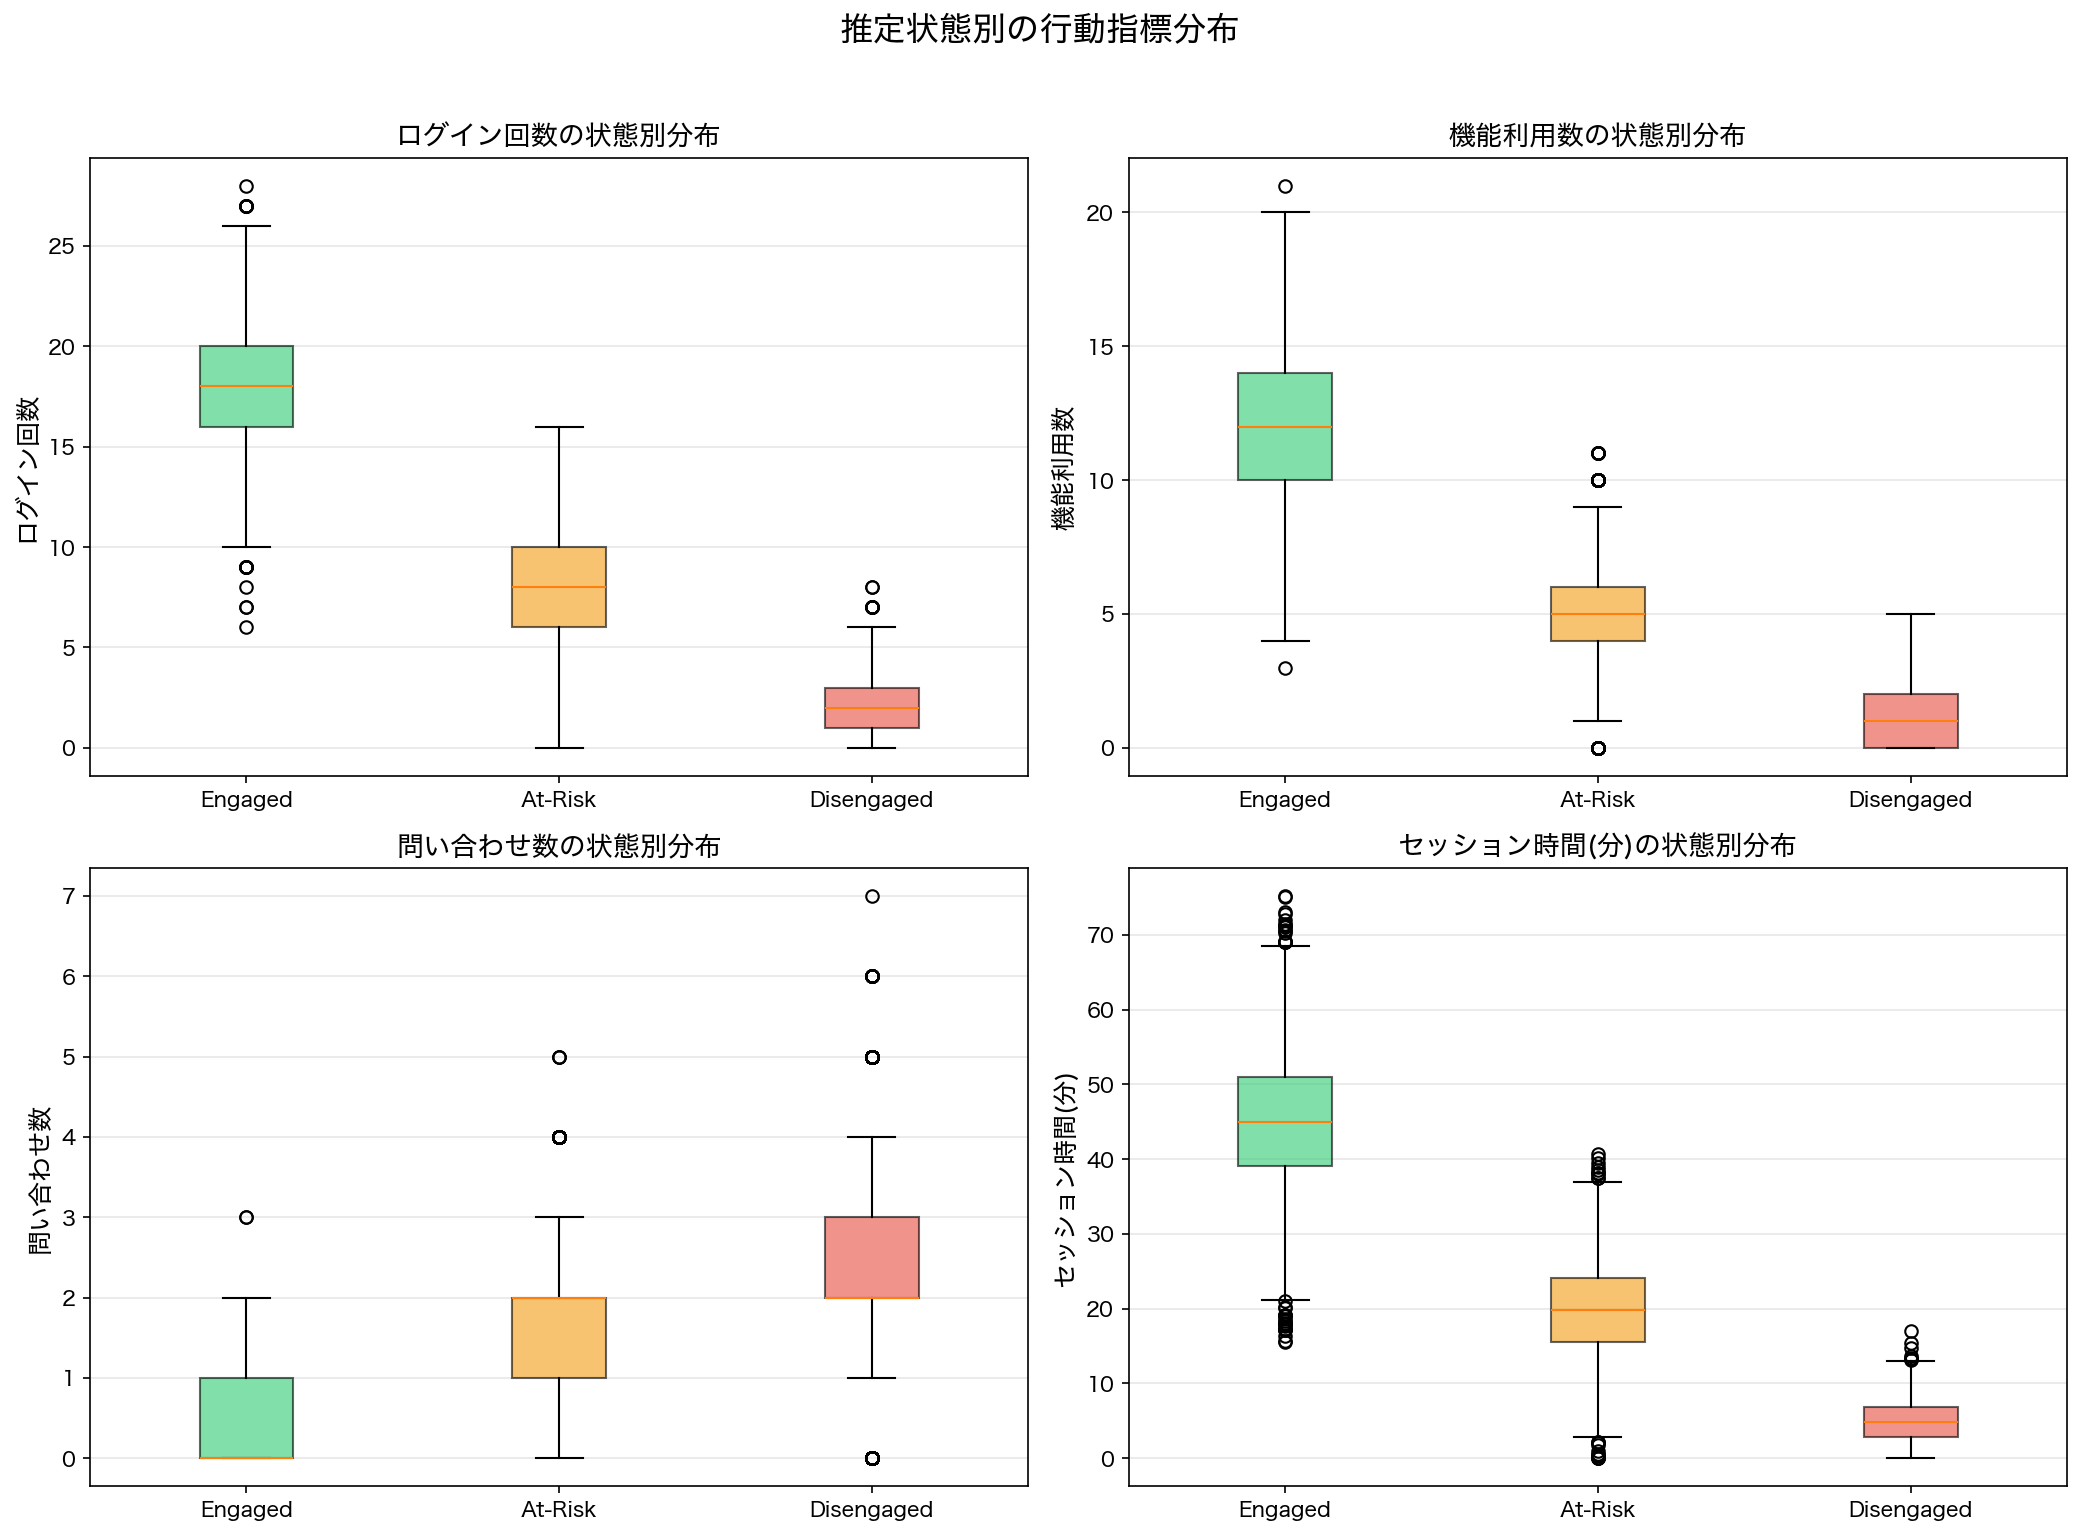
最終的に得られた推定パラメータを使い、ビタビアルゴリズム(Viterbi Algorithm)で各ユーザーの各週における最尤状態系列を復元しました。ビタビアルゴリズムは、観測データに対して最も確率の高い隠れ状態の系列を動的計画法で効率的に求める手法です。
モデルは正しく学習できたか
シミュレーションでは、あらかじめ正解がわかっているダミーデータを使っているため、「モデルが推定した結果」と「本当の答え」を比べることができます。結果として、モデルはほぼ正確に正解を再現できました。
各状態の特徴をどれだけ正確に捉えたか
下の表は、正解の数値とモデルが推定した数値の比較です。ほぼ一致していることがわかります。
| 観測変数 | 状態 | 真の値 | 推定値 |
|---|---|---|---|
| ログイン回数 | Engaged | 18.0 | 18.1 |
| ログイン回数 | At-Risk | 8.0 | 8.0 |
| ログイン回数 | Disengaged | 2.0 | 2.1 |
| 機能利用回数 | Engaged | 12.0 | 12.0 |
| 機能利用回数 | At-Risk | 5.0 | 5.0 |
| 機能利用回数 | Disengaged | 1.0 | 1.1 |
| サポート問い合わせ | Engaged | 0.3 | 0.4 |
| サポート問い合わせ | At-Risk | 1.5 | 1.5 |
| サポート問い合わせ | Disengaged | 2.5 | 2.5 |
| セッション時間 | Engaged | 45.0 | 45.0 |
| セッション時間 | At-Risk | 20.0 | 19.8 |
| セッション時間 | Disengaged | 5.0 | 5.0 |
すべての変数において、推定値が真の値とほぼ一致していることがわかります。最大の誤差はセッション時間のAt-Risk状態で0.2分(真の値20.0に対して推定値19.8)であり、このダミーデータでは小さい誤差でした。実用上の精度は、未使用データでの予測と解約実績との対応で評価する必要があります。
遷移行列の復元精度
| 遷移パターン | 真の値 | 推定値 | 誤差 |
|---|---|---|---|
| Engaged → Engaged | 0.850 | 0.856 | +0.006 |
| Engaged → At-Risk | 0.120 | 0.118 | -0.002 |
| Engaged → Disengaged | 0.030 | 0.026 | -0.004 |
| At-Risk → Engaged | 0.150 | 0.149 | -0.001 |
| At-Risk → At-Risk | 0.700 | 0.706 | +0.006 |
| At-Risk → Disengaged | 0.150 | 0.144 | -0.006 |
| Disengaged → Engaged | 0.050 | 0.051 | +0.001 |
| Disengaged → At-Risk | 0.180 | 0.186 | +0.006 |
| Disengaged → Disengaged | 0.770 | 0.764 | -0.006 |
すべての遷移確率において、誤差は0.006以内に収まっています。このシミュレーションの表では、設定した遷移確率に近い値が得られています。
| 遷移元 | Engagedへ | At-Riskへ | Disengagedへ |
|---|---|---|---|
| Engaged | 0.856 | 0.118 | 0.026 |
| At-Risk | 0.149 | 0.706 | 0.144 |
| Disengaged | 0.051 | 0.186 | 0.764 |
本文掲載の点推定値。表示値は丸めているため行合計が1から0.001ずれる。図のカラーバーが数値に重なるため表へ置き換えた。
推定パラメータから得られるビジネスインサイトの要約
個別ユーザーの状態推移
モデルの有用性をより具体的に理解するため、個別ユーザーの状態推移を見てみましょう。以下の図は、あるユーザーの52週間にわたる行動データと、モデルが推定した隠れ状態の変化を示しています。
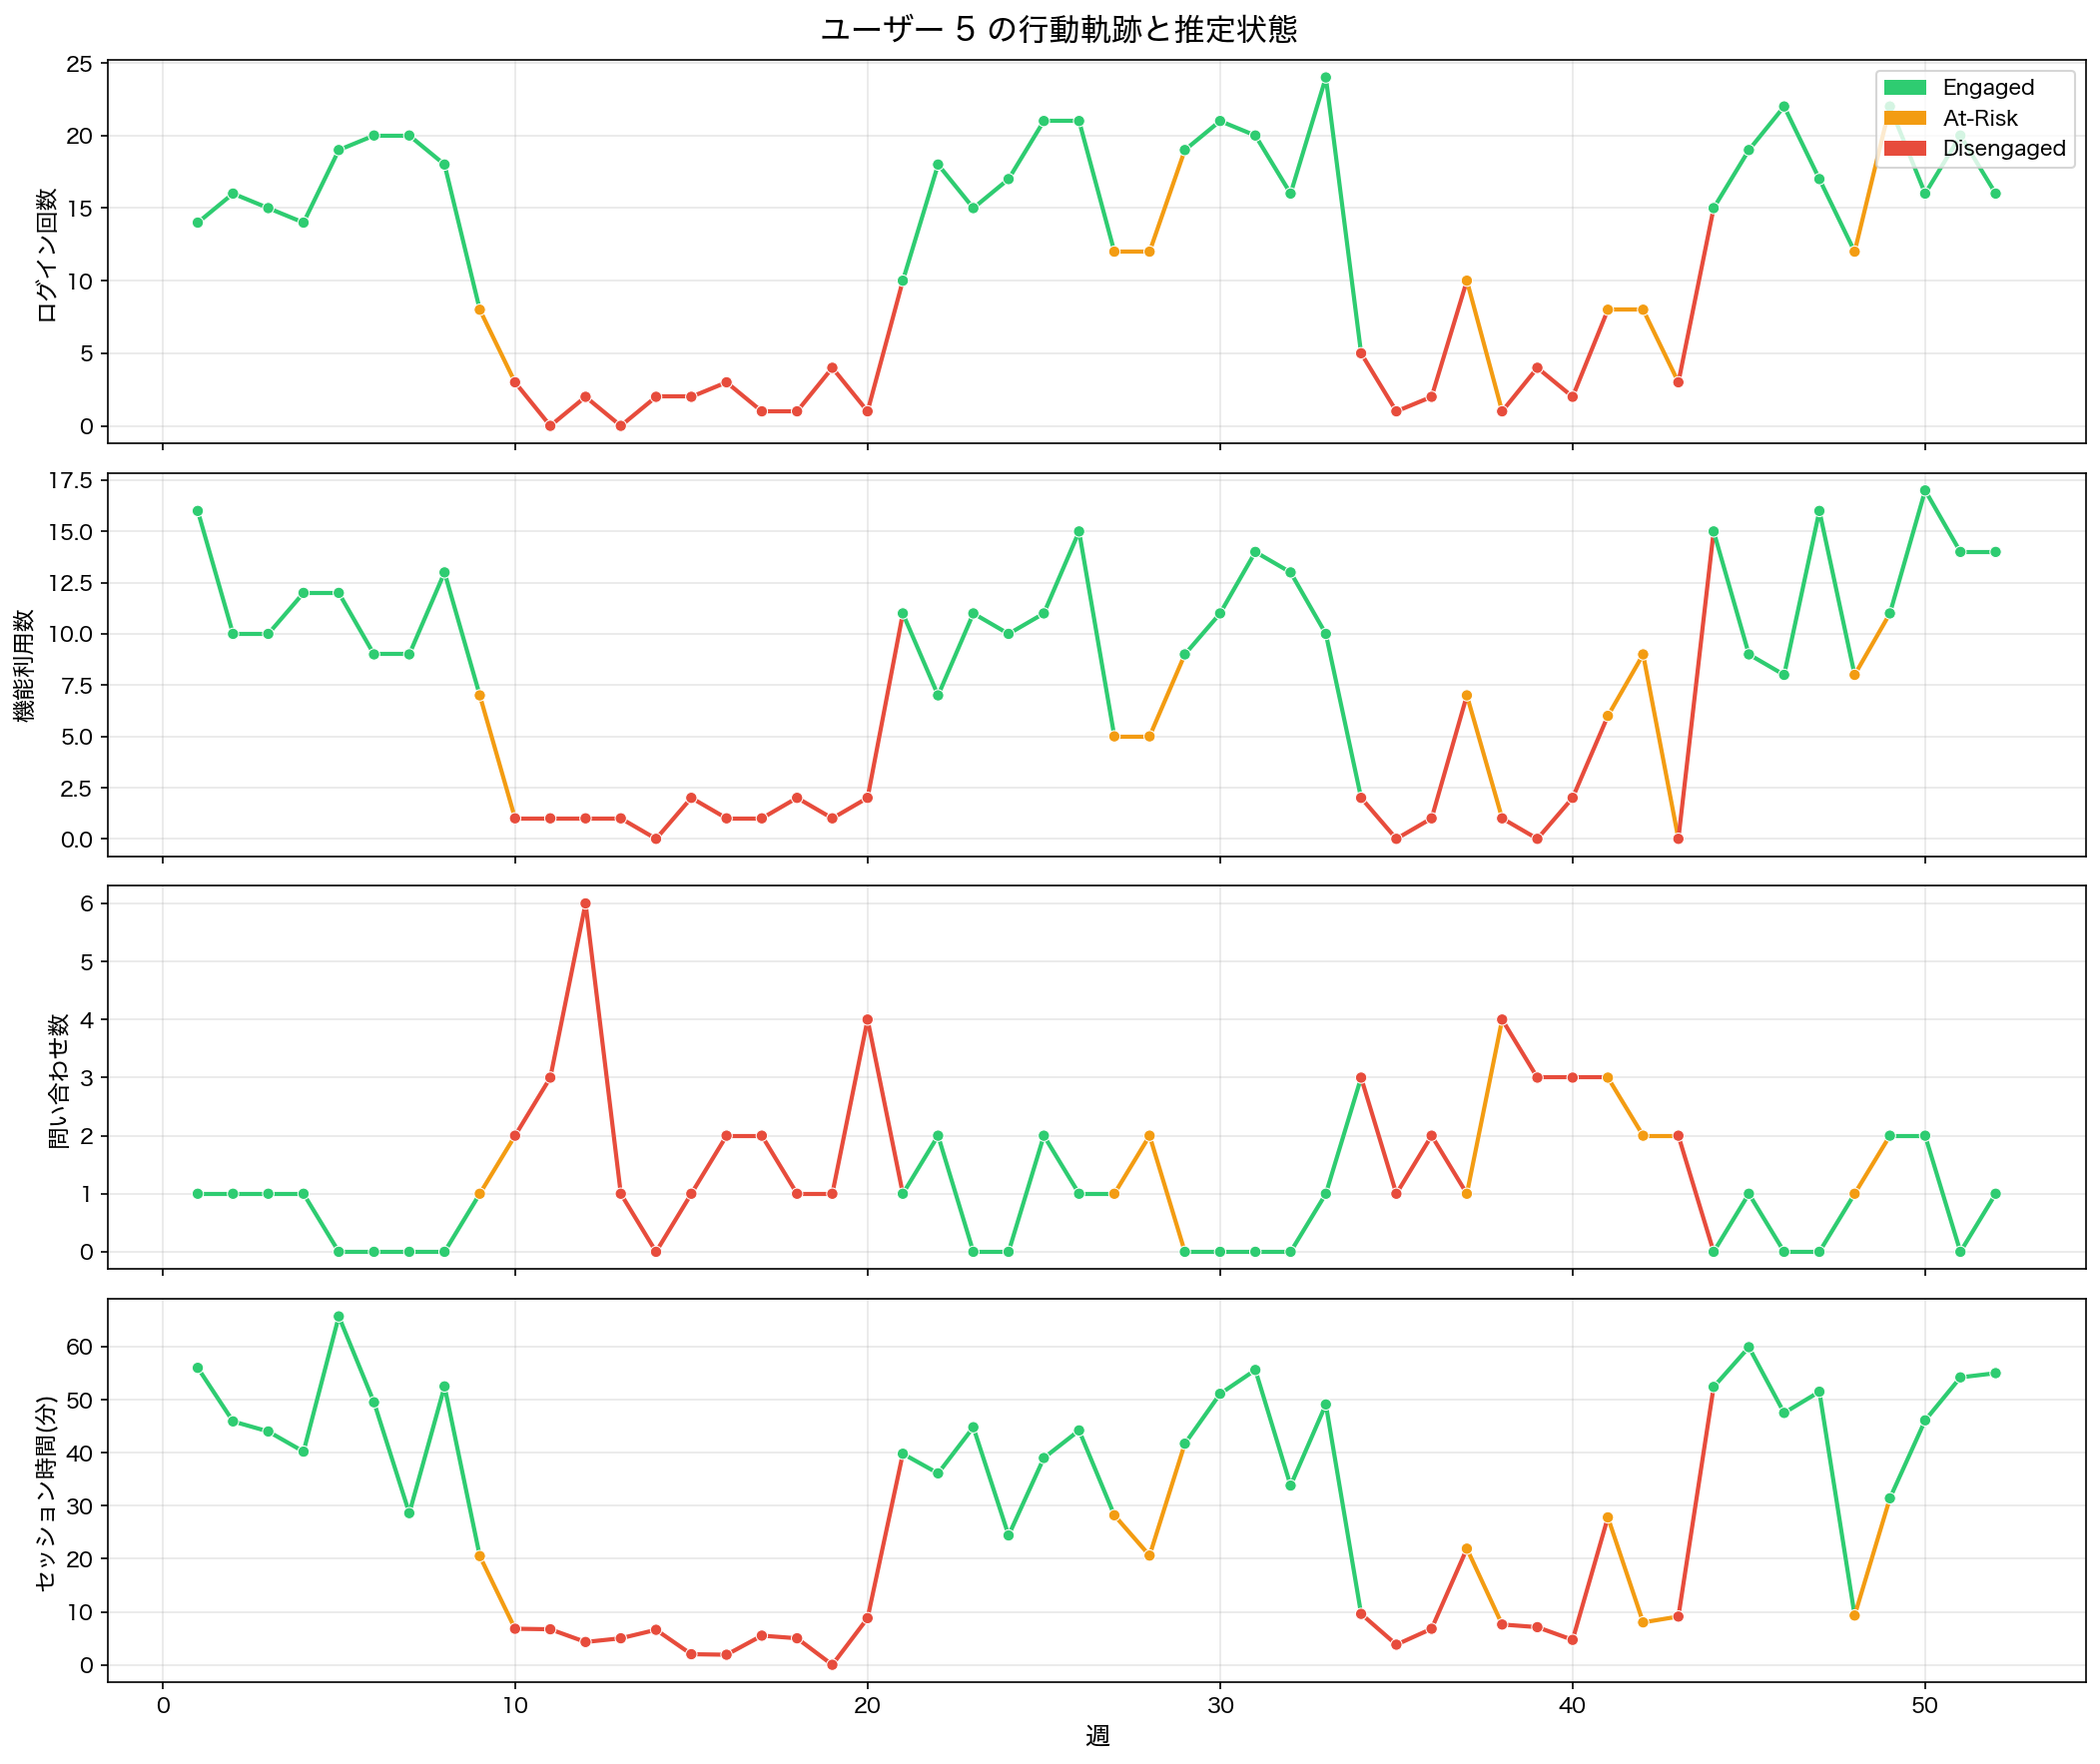
個別ユーザーの行動データと推定された隠れ状態の推移。行動指標の変化に連動して状態が遷移する様子が読み取れる
この図は、観測された行動に対応して推定状態が変わる例です。全期間のデータを使った推定には、その時点より後の情報も含まれます。早期検知の性能を測る際は、各週までに得られたデータだけで推定し、将来の解約実績と比較します。
このHMMは4指標の組み合わせと状態の推移を利用します。しきい値方式と比べて早く検知できるかは、同じデータで誤警報率や解約までの日数を比較して判断します。
状態確率の時系列
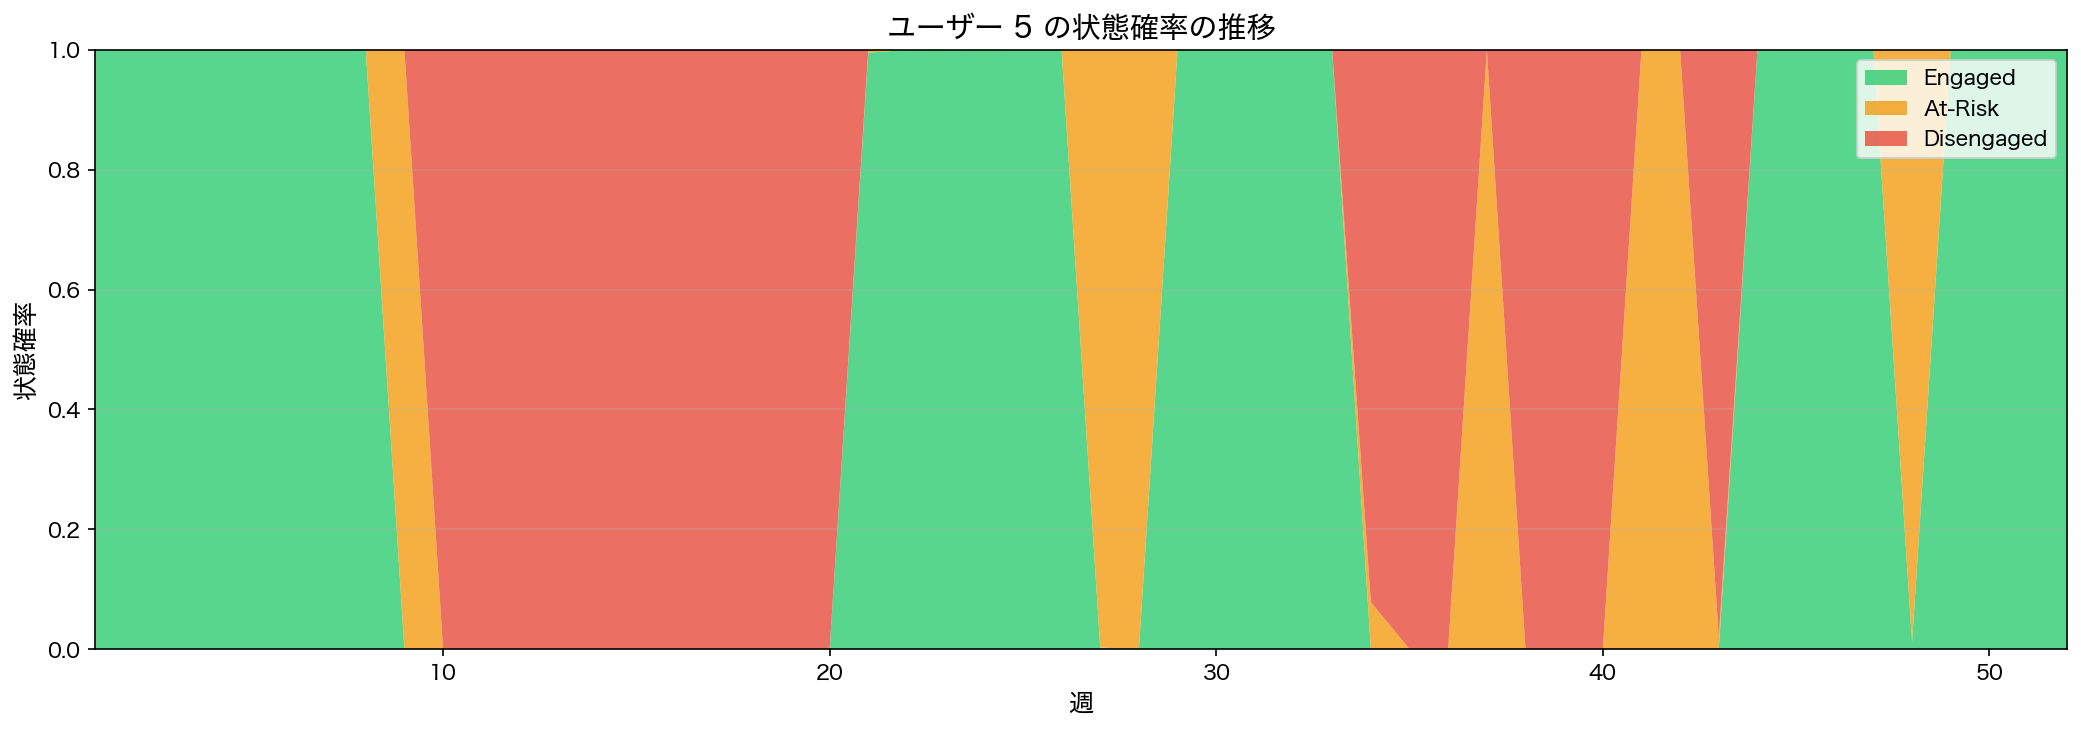
各時点における3つの隠れ状態に属する確率の推移。確率分布で状態を表現することで、介入の優先度を定量的に判断できる
上の図は、同じユーザーについて、各週で3つの状態それぞれに属する確率をプロットしたものです。ビタビアルゴリズムは、系列全体として最も確率の高い状態の並びを求めます。Forward-Backward法は、全観測期間を条件に各時点の状態確率を求めます。運用時の当週判定では、未来のデータを含めないフィルタリングを使います。
確率表示がもたらすビジネス価値
「このユーザーは要注意です」という曖昧な判定ではなく、「Engagedの確率32%、At-Riskの確率55%、Disengagedの確率13%」のように数字で状態を見える化できます。これにより、At-Risk確率が50%を超えたユーザーをカスタマーサクセスチームに自動でエスカレーションする、といった具体的な運用ルールを設計できるようになります。
ユーザー基盤全体のヘルス
個別ユーザーの状態推移だけでなく、ユーザー基盤全体の「健全性」を俯瞰的に把握することも重要です。以下の図は、52週間にわたるユーザー基盤の状態構成比の推移を示しています。
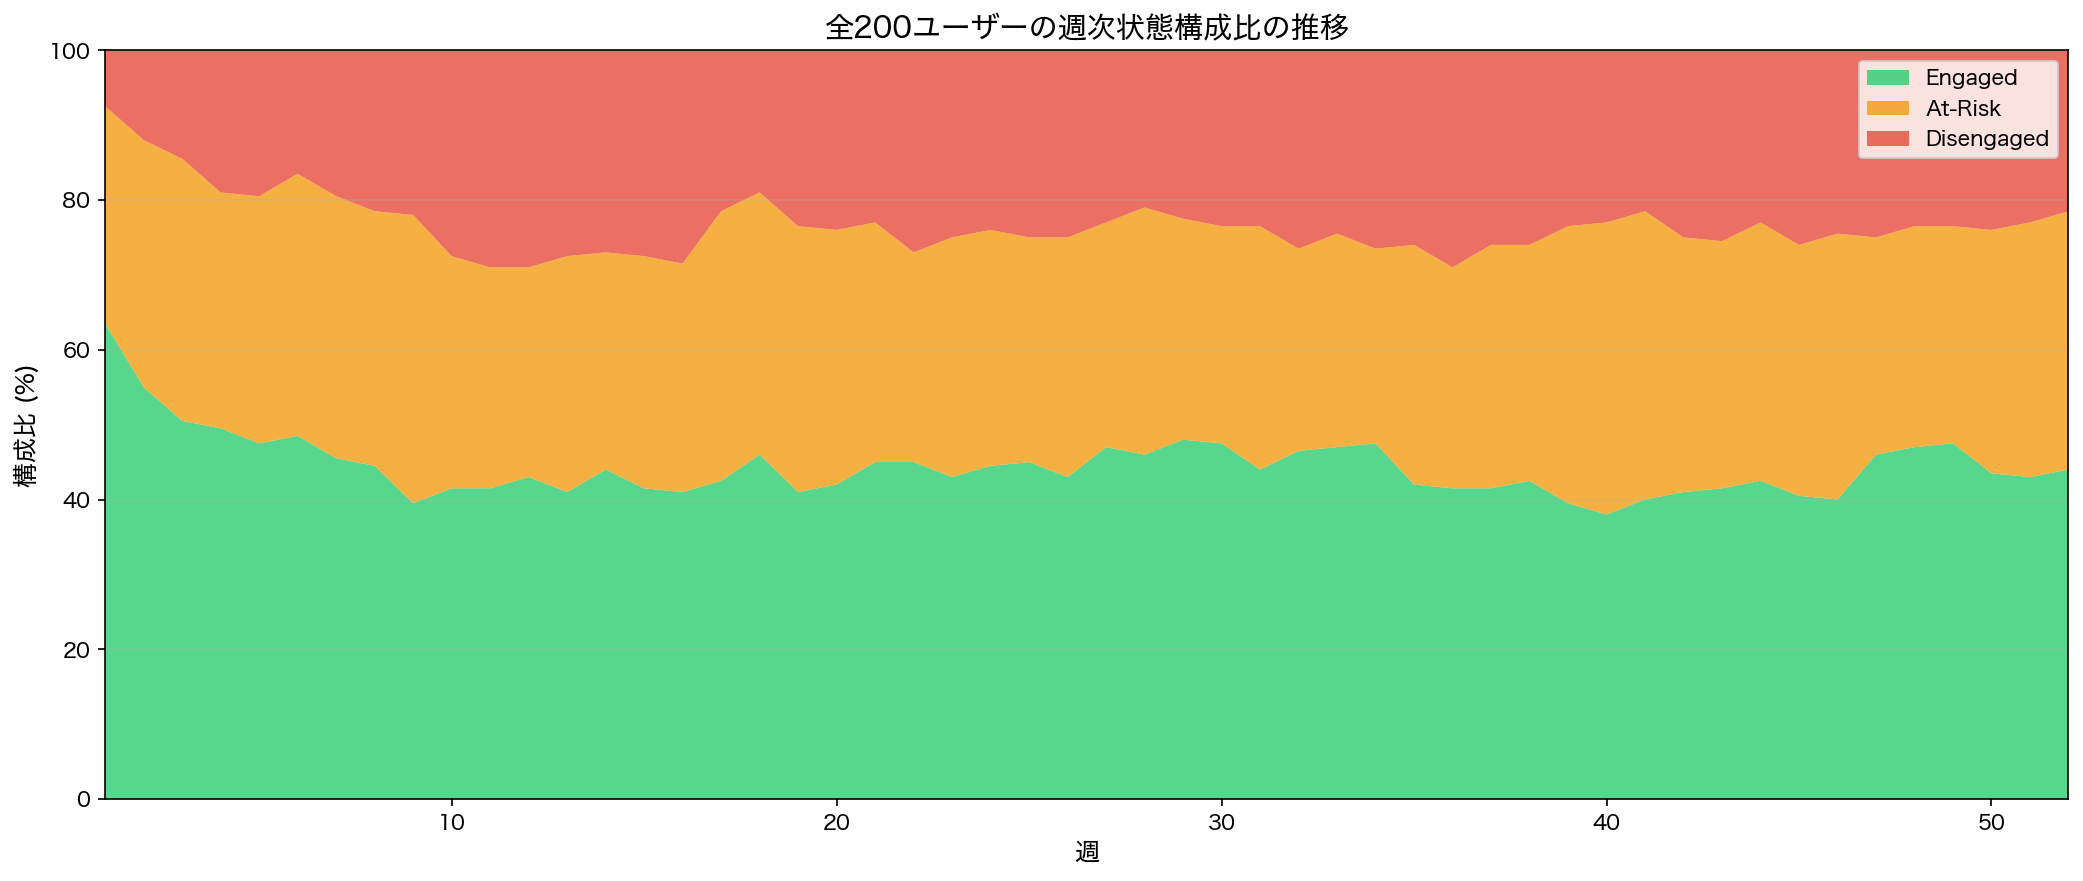
52週間にわたるユーザー基盤の状態構成比の推移。Engaged、At-Risk、Disengagedの比率変化で利用動向を要約する。解約の先行指標となるかは未検証
この図は、経営層やマネージャーにとって非常に価値のある情報源になります。たとえば、以下のような判断に活用できます。
- トレンドの早期察知 Engaged比率が徐々に低下し、At-Risk比率が上昇しているトレンドがあれば、プロダクトや価格設定に構造的な問題がある可能性を示唆する
- 施策効果の検証 カスタマーサクセス施策を投入した時期の前後で、At-RiskからEngagedへの回復率が変化したかを確認できる
- 季節性の把握 年度末や四半期末に特定の状態遷移が集中するパターンを発見できる
従来のMRR(Monthly Recurring Revenue)やNRR(Net Revenue Retention)といったトップラインの指標は「結果」を示しますが、状態構成比は利用動向を要約する指標です。解約の原因や先行指標と位置づけるには、将来の解約との関係を別データで検証する必要があります。
ビジネスへの応用 チャーンリスクスコア
直近の状態確率から参考スコアを作り、フォロー候補の順序づけに使います。このスコアと実際の解約率の対応は、別途検証が必要です。
スコアの算出ロジック
元コードでは、直近のAt-RiskとDisengagedの状態確率を重みづけしてスコアにします。遷移確率や状態悪化トレンドは、掲載図を作るスコア式には入っていません。
チャーンリスクスコアの考え方
参考スコア(0〜1)= At-Risk確率 × 0.5 + Disengaged確率。0〜100で表示する場合は100倍する。
以下は200人版での分類例です。元コードのスコアは0.5 × At-Risk確率 + Disengaged確率で、0.3未満をLow、0.3以上0.6未満をMedium、0.6以上をHighとしています。重みとしきい値は例示であり、解約確率を推定・校正した値ではありません。
| リスクカテゴリ | ユーザー数 | 割合 | 推奨アクション |
|---|---|---|---|
| Low(低リスク) | 88 | 44% | アップセル・クロスセルの提案 |
| Medium(中リスク) | 69 | 34.5% | ヘルスチェックの実施・活用支援 |
| High(高リスク) | 43 | 21.5% | 即時のエスカレーション・経営層面談 |
| 1,000人版の分類 | 人数 | 割合 |
|---|---|---|
| Low | 414 | 41.4% |
| Medium | 339 | 33.9% |
| High | 247 | 24.7% |
旧図に掲載された人数を表にし、割合を人数から再計算しました。直前の200人版の表とは別の結果です。実際の解約率や介入効果を示すものではありません。
従来のしきい値アラートとの違い
冒頭で紹介した「しきい値ベース」のアラート(例:ログインが週5回を下回ったら警告)と、HMMベースのリスクスコアはどう違うのでしょうか。
HMMベースの参考スコアの特徴
- 「流れ」を見る HMMは状態の遷移をモデル化します。しきい値方式でも、前週比や移動平均などを入力に使えます。「先週まで活発→今週急に減少」と「もともと少ない」を区別できます
- 複数の指標を総合判断 このHMMは4つの指標を同時に扱います。しきい値方式でも複数指標を組み合わせる設計は可能です
- 白黒ではなくグラデーション しきい値は「要注意 or 問題なし」の二択ですが、HMMは「At-Risk状態の確率55%」のように連続的な数値を出すため、優先度をつけやすくなります
- 未来を予測できる 遷移確率を使って「この顧客が4週間後に離脱気味になる確率」を計算できます。将来状態の確率も推定できますが、しきい値方式との性能比較は別途必要です
介入戦略への接続
HMMの推定結果は、具体的な介入戦略の設計に直接活用できます。特に重要なのは、状態遷移のパターンごとに異なるアクションを定義することです。
遷移パターン別の介入アクション
| 遷移パターン | 確率 | 推奨アクション | タイミング |
|---|---|---|---|
| Engaged → At-Risk | 11.8% | プロアクティブなヘルスチェック連絡 | 遷移検知から1週間以内 |
| At-Risk → At-Risk(継続) | 70.6% | 活用事例の共有・トレーニング提案 | At-Risk状態が2週間継続時 |
| At-Risk → Disengaged | 14.4% | 経営層を含めたエスカレーション面談 | 遷移検知後すぐ |
| Disengaged → At-Risk(改善兆候) | 18.6% | 回復を後押しするサポートの強化 | 遷移検知のタイミング |
| At-Risk → Engaged(回復成功) | 14.9% | 回復要因の分析とナレッジ蓄積 | 回復確認後 |
At-Risk状態の平均滞在期間
At-Riskに連続してとどまる平均期間は約3.4週間
自己遷移確率0.706を用いると、At-Riskに連続してとどまる平均期間は1 ÷ (1 − 0.706) ≈ 3.4週間です。退出先にはEngagedへの回復とDisengagedへの移行の両方が含まれます。これは解約までの時間でも、介入できる猶予でもありません。
週次で状態を更新してフォロー候補を担当者へ通知する運用は考えられます。対応期限は、実際の解約までの日数、検知の遅れ、対応にかかる時間を確認して決めます。
このシミュレーションでは、しきい値方式との検知時期の比較や介入効果は検証していません。両方式を同じ過去データで比較し、誤警報率と解約までの検知日数を評価します。
まとめ
HMMによる行動ログの状態推定例を示しました。元実装はMAP型の点推定であり、心理状態の同定や解約予測、介入効果の検証結果ではありません。実務利用では、当週までの情報だけで算出したスコアと将来の解約実績を比較します。
この手法で何がわかるようになるか
- 利用パターンを状態として要約する ログイン回数やサポート件数などの数字の裏にある、モデル上の3つの利用状態を確率で表せる。心理状態との対応は未検証
- 対応候補の整理に使う リスクスコアに基づいて顧客を自動分類し、それぞれに適した対応を提案できる
- 手遅れになる前に動ける 状態の遷移確率を使って「来週At-Riskへ移るモデル上の確率」を予測し、先回りでフォローできる
- カスタマーサクセスの効率が上がる 全顧客に同じ対応をするのではなく、フォロー候補を絞り込める。効率改善の有無は別途検証する
蓄積した行動ログは、利用状態の変化を調べる材料になります。HMMの推定値は、担当者がフォロー候補を検討する際の情報として使えます。
Salesforce Data Cloud、Snowflake、Databricksなどに行動ログデータをお持ちであれば、まずは小規模なデータで試してみることをおすすめします。「自社のデータでも本当にこんなことができるのか」を確認する第一歩として、ぜひ検討してみてください。
はてなベースは「データの活用」まで伴走します
多くの企業が「データ統合」には投資したものの、その先の「分析」と「施策への接続」でつまずいています。はてなベースは、データ基盤の構築から、本記事で紹介したような高度な分析モデルの設計・実装、そして現場のカスタマーサクセスチームが日常的に使えるオペレーションへの落とし込みまで、一貫して支援しています。「データはあるが、使い方がわからない」という状態から抜け出すための最初の一歩を、ぜひご一緒させてください。