2026年10月17日、中国のAI企業 DeepSeek が新しいモデル「DeepSeek-V4.1-Flash-1017」を公開しました。9月に出した DeepSeek-V4.1-Flash を手直ししたもので、名前の末尾の1017は、公開日の10月17日にあたります。モデルの中身にあたるは、誰でも商用に使える で Hugging Face に置かれています。
DeepSeek が公表した比較では、AIにパソコン作業や業務の自動化を任せる種類のテストで、Anthropic の Claude Opus 5 や OpenAI の GPT-5.6 Sol を上回る項目があります。一方で、DeepSeek という名前を聞くと「中国の会社のAIに社内の資料を入れて大丈夫か」と心配になる方も多いはずです。この記事では、その心配に正面から答えます。結論を先に言うと、社内のサーバーで動かせば社外秘の資料にも使えます。はてなベースでは、その形をハテナレッジAI プラスとしてお届けしています。
答えは使い方で分かれます。DeepSeek のアプリや API に社外秘の資料を入れるのは避けてください。入力した内容は中国のサーバーに保存され、中国の法令が適用されると、個人情報保護委員会が注意を促しています。これに対して、公開された重みを自社のサーバーに置いて動かし、社外への通信を止めておけば、質問も資料も DeepSeek 社には届きません。社外秘の資料を守れるかどうかは、モデルを作った国では決まりません。データがどこへ送られるか、サーバーを誰が管理するかで決まります。社内で動かす場合でも、入手元の確認、答えの偏りへの備え、機材の用意の3点は残ります。
この記事の調べ方
モデルの仕様と比較の数値は、DeepSeek が Hugging Face に載せたモデルの説明と、DeepSeek の開発者向けの更新履歴から転記しました。データの扱いは個人情報保護委員会とデジタル庁の注意喚起を、安全性の評価は米国国立標準技術研究所(NIST)の報告書を、推論用のソフトの挙動は各ソフトの公式の説明を根拠にしています。はてなベースではこのモデルをまだ動かしていません。性能の数値はすべて公表値です。
DeepSeek-V4.1-Flash-1017 はどんなモデルか
DeepSeek-V4.1-Flash は、文章と画像の両方を読める大規模言語モデルです。元のモデルの説明によると、本体の大きさは5,520億パラメーターあります。ただし質問に答えるときに実際に動かすのはそのうち80億〜160億だけで、必要な部分だけを呼び出すという作りです。一度に読める長さは100万で、分厚い規程集や契約書の束をまとめて渡せる長さです。
DeepSeek は 1017 を、9月のモデルの「小さな更新」と説明しています。推論、プログラミング、AIに作業を任せる使い方、画像の読み取りのすべてで点数が上がり、そのうえで作業にかかる時間と答えの長さが短くなったとしています。API の呼び出し名は deepseek-flash のままで、料金も変わっていません。API で使っている会社は、何もしなくても10月17日から新しいモデルに切り替わっています。
社内で動かす立場から見ると、大事なのは重みが公開されている点です。ライセンスは MIT で、商用利用や改変に追加の申請は要りません。重みのファイルは合計でおよそ510GBあります。家庭用のパソコンには収まらず、会社のサーバー室に置くAI専用のサーバーで動かす大きさです。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年10月17日(元の V4.1-Flash は9月10日) |
| 作った会社 | DeepSeek(中国・杭州) |
| 使い方 | Webサイト・アプリ・API、または重みを取り込んで自社のサーバーで動かす |
| ライセンス | MIT(商用利用・改変が可能) |
| 大きさ | 本体5,520億パラメーター、答えるときに動かすのは80億〜160億 |
| 一度に読める長さ | 100万トークン |
| 読めるもの | 文章と画像 |
| 重みのファイル | 合計およそ510GB |
表のうち「読めるもの」と「重みのファイル」の2行が、社内で動かすかどうかを考えるときの出発点になります。文章に加えて画像も読めるので、図面や写真の入った資料にも使える可能性がありますが、どこまで読めるかは自社の資料で試して確かめる必要があります。
他のモデルと比べた性能
DeepSeek は、前のモデルと、海外の主なモデル4つを並べた表を公表しています。比べる相手は、Anthropic の Claude Opus 5、OpenAI の GPT-5.6 Sol、中国 Moonshot AI の Kimi K3、中国 Zhipu AI の GLM-5.3 です。下の図はそのうち4項目を抜き出したものです。
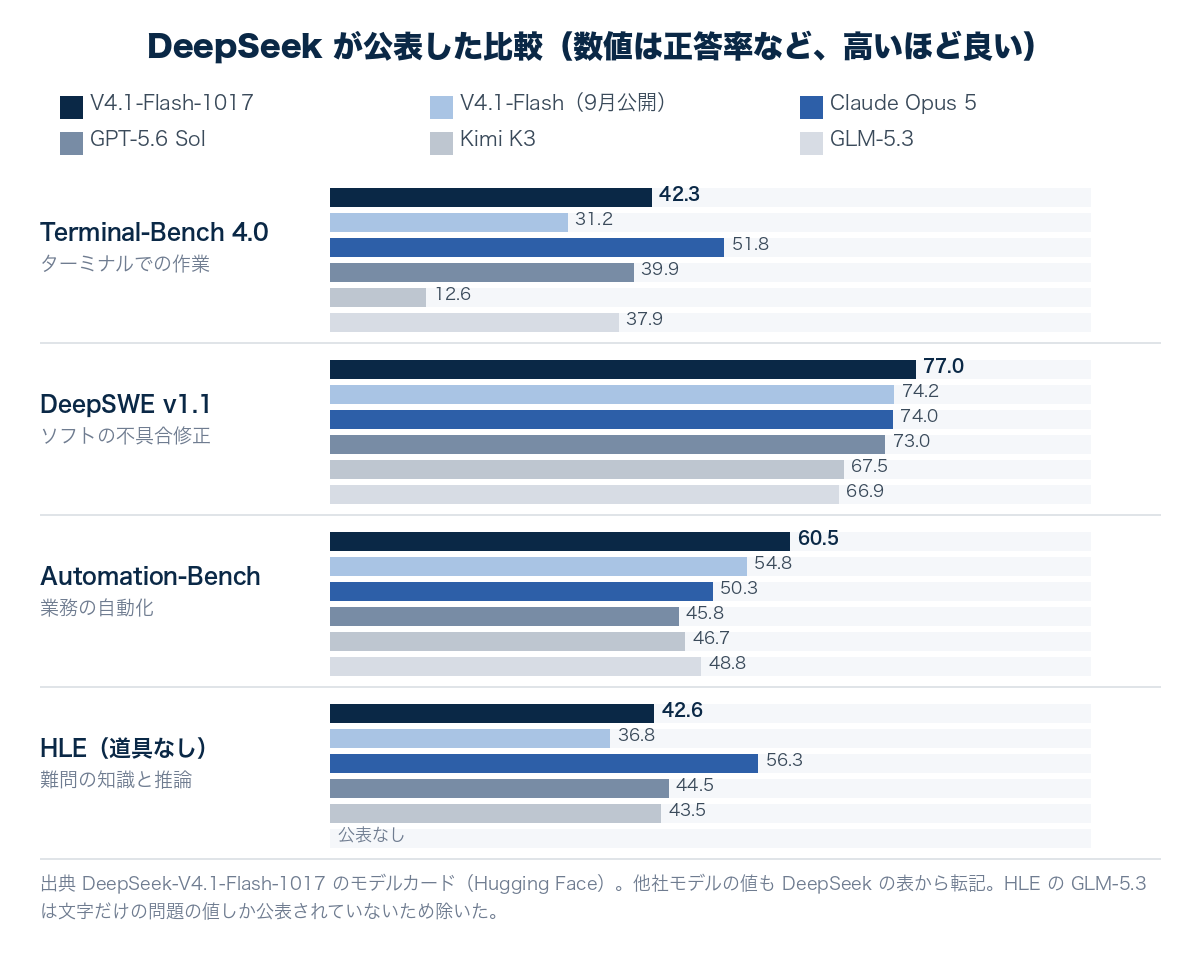
図の上から2つ目と3つ目のグループでは、1017 の棒が一番長くなっています。ソフトの不具合修正と業務の自動化のテストです。一方、同じくAIに作業を任せる種類でも、一番上のターミナルでの作業では Claude Opus 5 が上回っています。また、一番下の HLE(知識と推論の難問を集めたテスト)では、Claude Opus 5 が56.3点で、1017 の42.6点を13.7点離しています。表の全項目は次のとおりです。
| テスト(何を測るか) | V4.1-Flash-1017 | V4.1-Flash(9月) | Claude Opus 5 | GPT-5.6 Sol | Kimi K3 | GLM-5.3 |
|---|---|---|---|---|---|---|
| HLE 道具なし(難問の知識と推論) | 42.6(文字の問題のみ44.0) | 36.8 | 56.3 | 44.5 | 43.5 | 文字の問題のみ42.0 |
| Terminal-Bench 4.0(ターミナルでの作業) | 42.3 | 31.2 | 51.8 | 39.9 | 12.6 | 37.9 |
| DeepSWE v1.1(ソフトの不具合修正) | 77.0 | 74.2 | 74.0 | 73.0 | 67.5 | 66.9 |
| ProgramBench(プログラムを一から作る) | 29.1 | 20.3 | 37.0 | 23.0 | 17.5 | 19.0 |
| NL2Repo-Bench(説明文からソフト一式を作る) | 68.2 | 65.4 | 75.3 | 56.8 | 58.0 | 58.0 |
| Automation-Bench v1.0.6(業務の自動化) | 60.5 | 54.8 | 50.3 | 45.8 | 46.7 | 48.8 |
| Agents' Last Exam(AIに任せる難しい作業) | 35.4 | 31.8 | 28.6 | 26.7 | 27.6 | 28.5 |
| Apex Bench v1.1(内容の説明なし) | 72.1 | 64.6 | 65.8 | 54.3 | 47.8 | 56.6 |
| Chartography 道具あり(グラフの読み取り) | 83.0 | 78.9 | 84.0 | 79.9 | 68.1 | 公表なし |
| BabyVision 道具あり(画像の理解) | 92.5 | 89.6 | 94.1 | 88.9 | 85.7 | 公表なし |
| ZeroBench 道具あり(画像の難問) | 51.0 | 49.0 | 52.0 | 53.0 | 41.0 | 公表なし |
11項目を数えると、1017 は9月のモデルより全項目で点数が上がりました。Claude Opus 5 と比べると、勝ったのは不具合修正、業務の自動化、AIに任せる難しい作業、Apex Bench の4項目で、残りの7項目では及びません。GPT-5.6 Sol には11項目中9項目、Kimi K3 には10項目で高い点を取り、GLM-5.3 とは数値が並ぶ8項目すべてで差をつけています(HLE は文字の問題だけの点数どうしで比べた場合)。Apex Bench は何を測るテストか、DeepSeek の説明がありません。
この表を読むときに気をつけたい点が3つあります。1つ目は、すべて DeepSeek 自身の測定だという点です。他社のモデルの数値も DeepSeek の表から転記しており、各社が自分で公表した値と同じ条件で測ったかは、表からは分かりません。Terminal-Bench 4.0 は Claude Code の仕組みの上で、DeepSWE は別の仕組みの上で測ったと注記があり、テストごとに道具立てが違います。9月のモデルの数値も、9月に出た説明と今回の表とで一部が合いません(NL2Repo-Bench は9月の説明では64.0、今回の表では65.4)。
2つ目は、第三者の評価がまだ出ていない点です。AIの性能を独自に測っている Artificial Analysis の総合指標では、9月の V4.1-Flash が39点でした。同じ指標で、OpenAI が重みを公開している gpt-oss-120b は12点です。社内で動かせる公開モデルの中では上位にいると言えますが、1017 自体の評価は10月18日の時点でまだ載っていません。
3つ目は、日本語の力が公表された表からは分からない点です。元のモデルの説明には多言語の算数のテスト(MGSM)があり、会話用に仕上げる前の段階のモデルどうしの比較で、9月のモデルは80.2点と、その前の V4-Flash の85.7点を下回っていました。社内の規程や手順書に使うなら、日本語の資料で実際に質問して、答えの正しさを確かめてから決めるのが確実です。
「DeepSeek は危ない」と言われるのは、アプリと API の話
DeepSeek の安全性が日本で話題になったのは、2025年2月です。個人情報保護委員会が、DeepSeek のサービスについて注意を促す情報を出しました。内容は、サービスの利用に伴って DeepSeek 社が取得した個人情報を含むデータが中国にあるサーバーに保存されること、そのデータに中国の法令が適用されることの2点です。適用される法令の例として、中国の個人情報保護法、サイバーセキュリティ法、データセキュリティ法、国家情報法が挙げられています。
その3日後には、デジタル庁のデジタル社会推進会議幹事会が政府機関に向けて注意喚起を出しました。DeepSeek などの生成AIを業務に使う場合、原則として要機密情報は扱わないこと、使う業務の範囲をあらかじめ決めること、内閣サイバーセキュリティセンター(NISC)とデジタル庁に助言を求めて判断することを求めています。2つの注意喚起が問題にしているのは、社員が入力した質問や貼り付けた資料が、インターネットを通って DeepSeek 社のサーバーに届く使い方です。
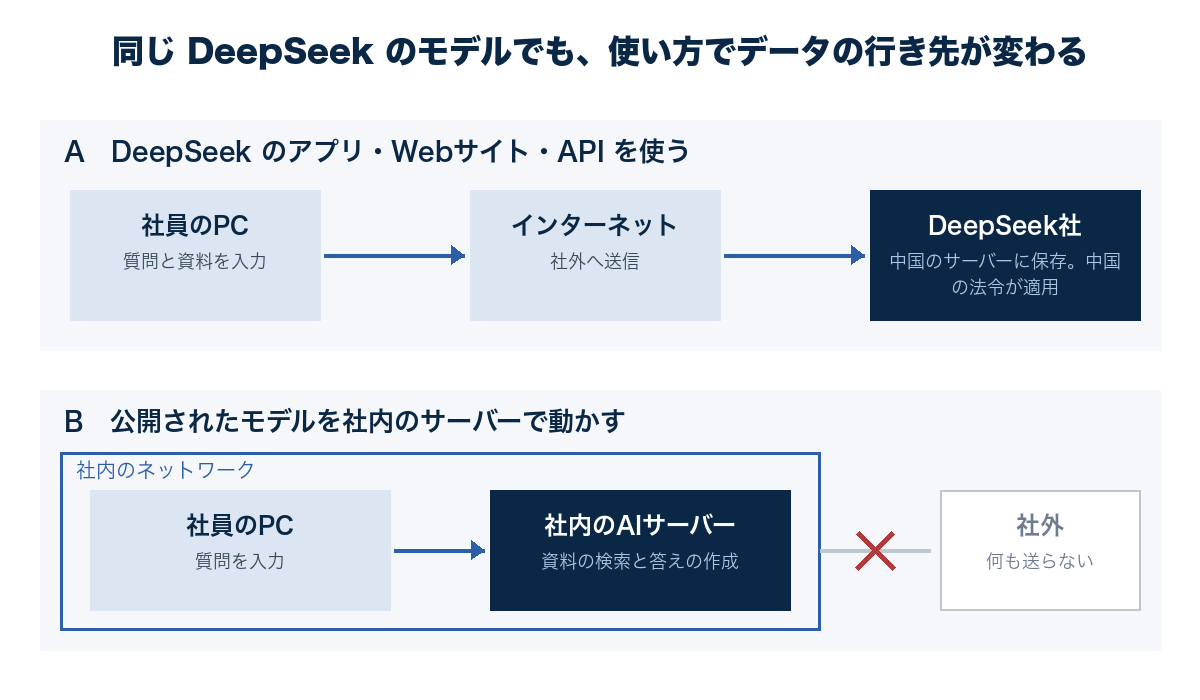
図の上の段と下の段では、同じ DeepSeek のモデルを使っていても、データの通り道がまったく違います。下の段のように社内のサーバーで動かすと、DeepSeek 社のサーバーとの通信そのものが発生しません。注意喚起が問題にした「中国のサーバーに保存される」という状態は、この使い方では起きません。
社内のサーバーで動かすと、なぜデータが外に出ないのか
最初に触れたとおり、重みはAIが学習した結果を数値として並べたファイルで、ファイル自体にはインターネットにつながる機能がありません。社内で動かすときは、推論用のソフト(モデルを動かして答えを作るソフト)にファイルを読み込ませます。社員の質問はこのソフトが受け取り、答えも社内のサーバーの中で組み立てます。1017 の重みには会話の形式を組み立てる部品が付いておらず、推論用のソフトの側も対応が始まったばかりです。たとえば SGLang は、公式の手順書で、まだ試験用の配布物でしか動かせないとしています。
1017 の重みは safetensors という形式で配られています。この形式は数値だけを収める作りで、読み込んだ時点でプログラムが勝手に動くことがないように作られています。ただし、推論用のソフトそのものが外へ通信することはあります。代表的な推論用ソフトの vLLM は、初期設定のままだと利用状況の統計を外部へ送ります。重みを取り込むときも、Hugging Face からのダウンロードで外部と通信します。重みを取り込み終えたら、ソフトの外部送信の機能を切り、AIサーバーから社外への通信を止めます。そうしておけば、何も送っていないことを自社の機器の記録で確かめられます。クラウドのAIでは、送ったデータの扱いは提供する会社の利用規約で決まります。社内で動かす場合は、送っていないことを自社の記録で示せます。
DeepSeek に限らず、「海外のAIは不安なので国産のモデルを選ぶ」という声もよく聞きます。ただ、ここまでの仕組みを踏まえると、国産のモデルかどうかはデータの守り方とは別の話です。国産のモデルでも、クラウドの API で使えば質問と資料は社外のサーバーに送られます。海外のモデルでも、社内のサーバーで動かせば社外には出ません。判断の軸は、次の表の3つです。
| 使い方 | 質問と資料の行き先 | 適用される法令 | サーバーを管理する人 |
|---|---|---|---|
| DeepSeek のアプリ・API | DeepSeek 社のサーバー(中国) | 中国の法令 | DeepSeek 社 |
| 国内企業のクラウドAI | その企業が契約するサーバー(国内とは限らない) | 契約と保存先による | その企業 |
| 公開された重みを社内で動かす | 自社のサーバー | 日本の法令 | 自社(または委託先) |
表の一番下の行だけが、データの行き先とサーバーの管理を自社で決められる使い方です。オンプレミス(自社の設備で動かす形)で生成AIを使う考え方そのものは、ローカルLLMとオンプレミス生成AIの判断基準でも詳しく整理しています。この使い方をサーバーの用意から社員が使う画面まで一式で導入したい場合は、ハテナレッジAI プラスをご覧ください。
社内で動かしても残る3つのリスク
社内で動かせばデータの行き先の心配は消えますが、それで全部が片付くわけではありません。社内で動かす場合にも残るリスクが3つあります。どれも導入の前に決めておけば抑えられるものです。
1. 入手元を間違えると、別物のモデルを動かすことになる
Hugging Face には、公開から1日あまりで 1017 の名前を含むモデルが公式のほかに56件上がりました(10月18日時点)。公式の重みを複製しただけのものや、小さく圧縮して少ない機材で動くようにしたものが多い一方で、11件は名前に「uncensored(検閲なし)」「abliterated(拒否を取り除いた)」などと付いており、名前から危ない依頼を断る仕組みを外したと分かるものです。誰が何を変えたかを確かめられないモデルを、社外秘の資料と一緒に動かすべきではありません。
社内で使う重みは、DeepSeek の公式アカウント(deepseek-ai)が公開したものに限ります。取り込む時点を固定し、ファイルの内容を示す値(ハッシュ値)を記録しておけば、あとで中身が入れ替わっていないかを確かめられます。推論用のソフトと、それが使う部品も、公式の配布元から取り込みます。ただし、公式の重みでも、学習の段階で仕込まれた悪い振る舞いがあるかどうかは、ファイルを調べても見つけられません。この点は、次の2つ目のリスクと同じ備えで抑えます。
2. 答えの偏りと、悪意ある指示への弱さ
米国国立標準技術研究所(NIST)は2025年9月、DeepSeek の当時のモデル3つ(R1、R1-0528、V3.1)を米国のモデルと比べた報告書を出しました。R1-0528 を使ったAIエージェントは、作業を横取りしようとする悪意ある指示に従う割合が米国のモデルの約12倍でした。中国政府の立場に沿った不正確な説明を返す割合も、約4倍だったとしています。
この評価は 1017 を測ったものではありません。ただ、同じ会社の新しいモデルでも同じ傾向が残っている可能性は考えておくべきです。対策は、AIに与える権限を絞ることです。メールの送信やファイルの削除などをAIに任せず、社内の資料を検索して答えるだけの使い方にすれば、悪意ある指示に従ったときの被害は小さく抑えられます。答えに根拠の資料を付け、人が元の資料で確かめる流れにしておくと、偏った答えにも気づけます。社内の資料の中に、AIへの指示に見える文が紛れ込んでいる場合も同じです。社内で動かしても、その指示にAIが従うことまでは防げないので、権限を絞る備えがここでも効きます。
3. 機材の用意と、モデルの入れ替え
重みだけで約510GBあり、GPU(AIの計算に使う部品)のメモリは、実際には読み込んだ文章を覚えておく分も上乗せで要る見込みです。DeepSeek が示す動かし方の手本も、8つに分けて動かす例になっています。圧縮した派生モデルなら必要な機材は減りますが、答えの質が下がることがあり、1つ目のリスクとの兼ね合いになります。
また、海外の報道では、中国政府が重みの公開に対する規制を強める計画があると伝えられています。今後の新しいモデルが同じように公開され続けるとは限りません。すでに取り込んだ重みは MIT ライセンスのまま使い続けられますが、AIを導入する会社の側で、将来は別の会社のモデルに入れ替える前提の仕組みにしておくのが無難です。モデルの入れ替えで業務が止まらないようにする手順は、AIのモデルの更新・廃止に備える運用にまとめています。
3つのリスクへの備えを含めて、社内で動くAIをお届けします
ハテナレッジAI プラスは、公開されたAIのモデルをお客様の社内のサーバーで動かす社内AIチャットです。公式の重みの取り込み、社外への通信を止めたAIサーバーの構築、根拠の資料を付けて答える画面まで一式でご用意します。
ハテナレッジAI プラスなら、このモデルを社内に届けられる
ここまでの条件を自社だけでそろえるのは簡単ではありません。AIサーバーを選んで置き、公式の重みを取り込み、社外への通信を止め、社員がブラウザから質問できる画面と資料の検索の仕組みを作る必要があります。はてなベースのハテナレッジAI プラスは、この一式をお客様の社内に構築する社内サーバー型のAIチャットです。
ハテナレッジAI プラスは、Hugging Face で公開されている生成AIのモデルを、お客様の社内に置くAIサーバーで動かす仕組みです。DeepSeek-V4.1-Flash-1017 のように重みが公開された高性能なモデルも、社内のサーバーに載せてお客様にお届けできます。1017 は公開されたばかりなので、導入の際にはお客様の環境で動作と答えの質を確かめてから使い始めます。社員のPCからの質問、資料の検索、答えを作る処理まで社内のネットワークの中で完結し、社外に送るものはありません。
- 答えの下に、根拠にした資料の名前と該当する箇所が出るので、偏った答えや誤りに人が気づけます
- 資料は改訂ごとに管理し、新しいものを登録すると古いものは答えに使わなくなります
- 部署や業務ごとに、資料と記録を見られる人を決められます
- 先輩や責任者が認めた調べ物の結果をチームの記録として残し、次の人の答えに使えます(オプション)
- 社外からは、必要に応じて VPN で社内のネットワークにつないで使えます
どのモデルを載せるかは、扱う資料、使う人数、サーバーにかけられる費用で変わります。510GBの重みをそのまま動かすか、より小さいモデルで始めるかも、お客様の資料で試したうえで一緒に決めます。社外のサーバーに置いても問題のない資料が中心なら、クラウドのAIを使うハテナレッジAIのほうが手軽に始められます。
導入する前に決めておくこと
DeepSeek のモデルを社内で使うと決めたら、少なくとも次の5つを先に決めておくと、あとで社内の説明に困りません。社内のAI利用のルール全体は、中小企業のための生成AI運用ルール整備ガイドも参考にしてください。
- 社員が DeepSeek のアプリや Webサイトを使ってよいか(社外秘の資料を入れないことを含めて決める)
- 社内で動かす重みは、DeepSeek の公式アカウントから取り込んだものに限ること
- AIサーバーから社外への通信を止め、その記録を残すこと
- AIに任せるのは資料の検索と答えの作成までにし、送信や削除の権限を与えないこと
- 答えは根拠の資料で人が確かめてから使うこと
5つのうち3つ目と4つ目は、仕組みの作り方で決まります。社外に何も送らないことを社内の情報システムの担当者や監査に説明できる形で用意するのが、社内で動かす一番の利点です。ハテナレッジAI プラスでは、社外への通信を止めたAIサーバーと、根拠の資料を付けて答える画面をあわせて構築します。どこまでを社内で動かすかの線引きは、顧客データを外に出さずにAIを使うための6項目でも整理しています。
DeepSeek-V4.1-Flash-1017 は、公表値で見る限り、ソフトの不具合修正や業務の自動化など一部の項目で、海外の主なモデルを上回る性能を持っています。中国の会社が作ったモデルだという理由だけで候補から外す必要はありません。アプリや API に資料を入れない、公式の重みを社内のサーバーで動かして社外への通信を止める、AIの権限を絞る、の3つを守れば、社外秘の資料にも使える選択肢になります。自社でそろえるのが難しい場合は、ハテナレッジAI プラスの資料をお取り寄せいただくか、30分の無料相談でご相談ください。
社外に出せない資料を、社内のサーバーで動くAIに聞けるようにします
たとえば「図面や顧客情報をAIに使いたいが、クラウドには上げられない」「公開されたモデルを社内で動かしたいが、サーバー選びから分からない」といった場面で、AIサーバーの選定と構築、モデルの取り込み、社員が使う画面と資料の検索の仕組みまで、ハテナレッジAI プラスとしてお届けしています。業務フローへのAIエージェントの組み込みや、AIが使えるように社内のデータを整える作業もご相談いただけます。