Claude Fable 5.1 に切り替えたあと、同じような作業なのに請求額が伸びた、あるいは個人契約の利用上限に前より早く当たる。この記事は、その原因を「どこでトークンが増えたか」で4つに分け、Anthropic が公式に用意している手順と、無料の道具4本を、それぞれ何に効くかで整理したものです。費用の見積もりそのものはAI の API 費用をどう見積もるかの記事に、Fable 5.1 の性能面はリリース時の記事に書いています。
この記事の骨組み——公式の手順4つと、無料の道具4本という並べ方——は、Alvaro Cintas 氏(@dr_cintas)が X に公開した記事「Stop Fable 5.1 from wasting tokens」(原文・2026年9月2日)から借りました。ただし訳ではありません。各項目を公式資料と各リポジトリの説明で確かめ直し、確認が取れた記述だけを書き直しました。原文にあって裏が取れなかった数値は、その旨を書いて外しています。記載はいずれも2026年9月8日時点のものです。
トークンが増える場所は4つある。答える前に考える量(思考の深さ)、毎回送る文章の量(入力)、返ってくる文章の量(出力)、道具を呼ぶ往復の回数。まず自分の使用量の内訳を見て、増えている場所から手を打つ。思考の深さ(effort)の既定は Claude Code で high、Claude Cowork と claude.ai で medium。設定を変えること自体に費用はかからないが、公式の点検手順を回す試行にはモデル利用料が出る。
この記事の要約
まず、自分がどの払い方をしているのかを分ける
定額の契約で使っている人と、使った分だけ請求される API で使っている人とでは、見る数字も打つ手も変わります。同じ「トークンを減らす」でも、前者は上限に当たるまでの時間が延びる話、後者は請求額が変わる話です。先にどちらかを決めておかないと、この記事の手順が自分に当たるか判断できません。
| 使い方 | 費用の出方 | 先に確かめる数字 | この記事で効く手順 |
|---|---|---|---|
| 個人の Pro / Max 契約 | 月額は固定。使いすぎると利用上限に当たり、回復まで待つ | 上限に当たった回数と、そのとき何をしていたか | 手順1(effort)と手順3(指示文の点検)。道具なら rtk と codegraph |
| 会社が席を配っている | 席数分の月額。上限は利用者ごとに当たる | 上限に当たっている人数と、その人が回している作業 | 配る側の設定と共通の指示文に手順1・手順3を当てる |
| API を自社の仕組みから呼ぶ | 使った分だけ請求。入力・出力・キャッシュで単価が違う | 月次の入力・出力・キャッシュ読み取りのトークン数と金額 | 手順1〜4のすべて。特に手順2とキャッシュ |
担当者への頼み方も分かれます。API を使っているなら、請求の内訳を出せる人に「先月の入力・出力・キャッシュ読み取りをトークン数と金額で分けて出してほしい」と頼むところから始まります。席を配っているなら、管理画面で上限に当たっている人を出してもらい、その人が何をしていたかを聞く。個人契約なら、上限に当たったときの作業をメモに残すだけで足ります。記録が無いまま設定だけ変えると、効いたかどうかを誰も判定できません。
なぜ Fable 5.1 はトークンを食いやすいのか
公式資料には、費用に直接ひびく性質が3つ明記されています。どれも隠れた不具合ではなく、仕様として書かれているものです。
1つ目は文字の数え方です。Fable 5.1 のトークナイザ(文章をモデルが扱う単位に切り分ける仕組み)は Claude Opus 4.7 と同じで、公式資料には「Opus 4.7 より前のモデルと比べると、同じ文章がおよそ30%多いトークンになる」と書かれています。古いモデルから乗り換えると、送る文章を変えていないのに入力の数字が増えます。
2つ目は書き直しの癖です。ファイルを編集させたとき、Fable 5.1 は該当箇所だけを直すのではなく、ファイル全体を書き直す傾向が Fable 5 より強い。公式資料は「結果はたいてい同じだが、書き直しは出力トークンと時間を余計に使う」と書いています。出力は100万トークンあたり50ドルで、入力の5倍です。
3つ目は道具の呼び方です。エージェントとして動かす場面で、Fable 5 なら数個まとめて呼んでいた道具を、Fable 5.1 は1ターンに1回ずつ呼ぶことがある。公式資料は「答えの質は落ちないが、増えたターンの分だけトークンと往復と待ち時間がかかる」としています。
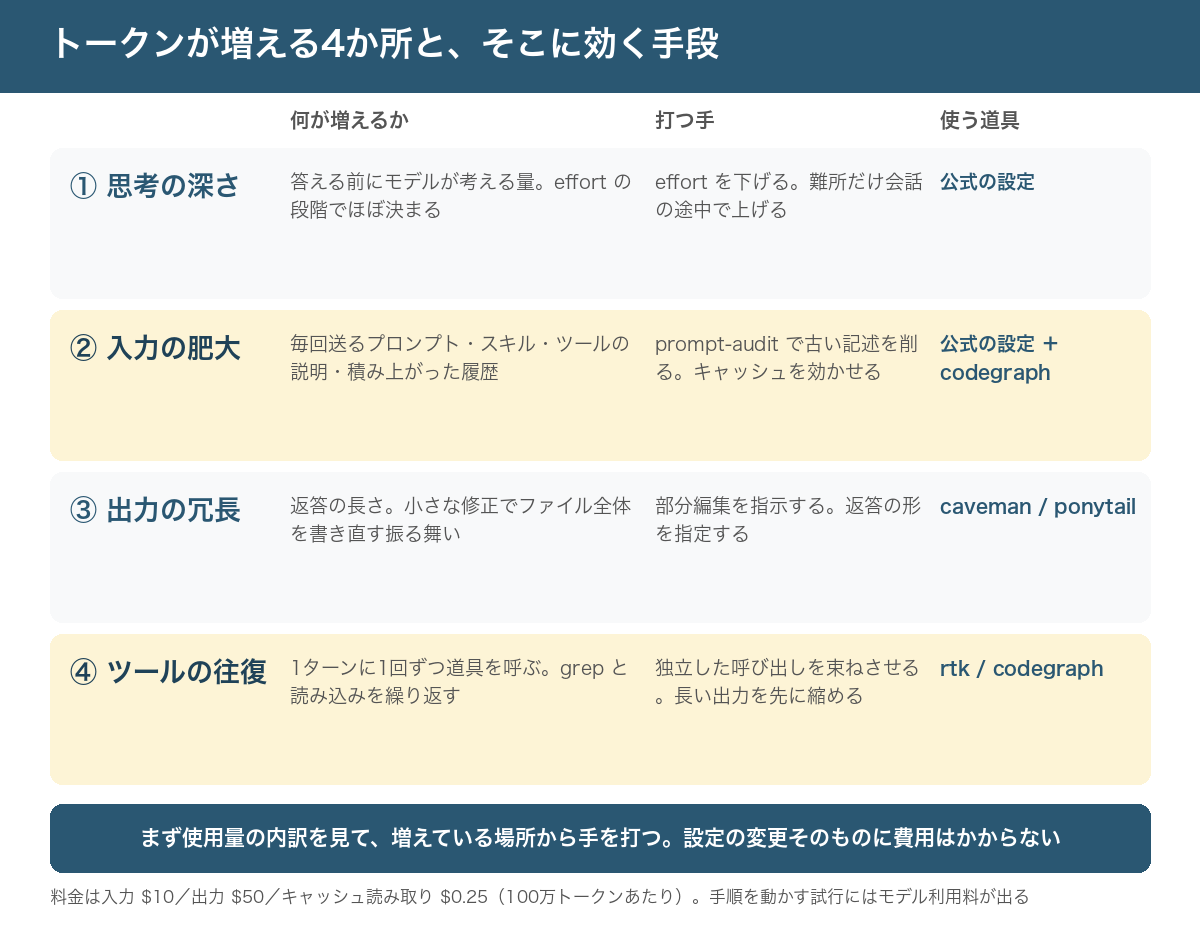
料金は公式の価格表に出ています。Fable 5.1 は Fable 5 と同価格で、キャッシュの読み取りだけが安くなりました。
| 区分 | 100万トークンあたり | 補足 |
|---|---|---|
| 入力 | 10ドル | 毎回送る指示文・履歴・ツールの説明・ファイルの中身 |
| 出力 | 50ドル | 返答と書き直したファイルの中身。入力の5倍 |
| キャッシュの読み取り | 0.25ドル | 入力の 0.025 倍。他の Claude モデルは 0.1 倍なので、ここだけ格段に安い |
| キャッシュの書き込み(5分) | 12.50ドル | 書き込む時点では入力より高い。読み返す回数で元を取る |
| キャッシュの書き込み(1時間) | 20ドル | 長い作業で使う |
| まとめて処理(バッチ) | 入力5ドル / 出力25ドル | 急がない処理は半額 |
キャッシュの読み取りが入力の40分の1という価格差が、この記事の前提になります。ただし安くなるのは、送る文章の先頭が前回と一致して読み取りとして数えられたときだけです。書き込みは1回12.50ドルで入力より高いので、読み返す回数が少なければ元が取れません。毎回わずかに違う文章を先頭に置く使い方なら、そこはまるごと10ドルの側で数えられます。
手順1 思考の深さ(effort)を見直す
effort は、答える前にどれだけ考えるかを決める設定です。low / medium / high / xhigh / max の5段階があり、Anthropic の発表によれば既定は使うサービスで違います。Claude Code は high、Claude Cowork と claude.ai は medium。API から呼ぶ場合の既定は high です。「Fable 5.1 は常に一番深く考える」という言い方は、少なくとも Cowork と claude.ai には当たりません。自分がどこから使っているかで、下げしろがあるかどうかが変わります。
なお Fable 5.1 は思考そのものを切れません。thinking を無効にする指定は 400 エラーが返り、深さの調整だけが手元に残ります。
公式のプロンプト指針の書き方は慎重です。「既定の high から始め、他の段階(low / medium / xhigh / max)を自分の評価にかけて試す」。そのうえで「medium では結果がおおむね Fable 5 と同等になり、費用は下がる。評価で品質が保てると分かった範囲で medium や low に下げる」「low では、他の Claude モデルを1段高い effort で動かすより、費用対効果で有利になることが多い」と続きます。下げてよい、ではなく、下げてよいことを自分で確かめてから下げる、という順序です。段階の名前を世代をまたいで信用するな、とも書かれています。「effort の段階名は、モデルが違えば同じ思考量を指さない」。前のモデルで high を使っていたから今回も high、という引き継ぎ方には根拠がありません。
Claude Code での切り替え方は設定ドキュメントにまとまっています。試すだけなら1行です。
| やり方 | 書き方 | 効く範囲 |
|---|---|---|
| 会話の途中で変える | /effort でスライダーを出す、または /effort low のように直接指定 | その場から次の要求に反映される |
| 起動時に指定する | claude --effort medium | そのセッションだけ |
| モデルごとの既定に戻す | /effort auto | 保存した段階を消す |
端末全体に効く環境変数、設定ファイルの既定値、スキル単位の上書きも用意されていて、書き方は同じドキュメントに一覧があります。まず試す段階では上の3つで足ります。
落とし穴が2つあります。1つは検索の頻度です。公式資料は「low では Fable 5.1 が検索や参照の道具を呼ぶ回数が減り、記憶から答えることが多くなる」と明記しています。動きの速い製品名のように、覚えている内容が古くなりやすい話題では、low のまま自信のある間違いが返ってきます。鮮度が要る場面だけ上げる、というのが公式の対処です。会話の途中で段階を変えてもキャッシュは無効になりません(ベータの mid-conversation-output-config-2026-07-01 ヘッダー)。
もう1つは逆方向です。xhigh と max では、長い成果物を頼むと、思考の中で下書きを書き上げてから返答として書き直すことがある。公式資料は「待ち時間が延び、出力トークンが増える」と書き、長い文書や大きなコードを一度に書かせる要求は high で回すことを勧めています。高い段階に置けば安全、ではありません。
公式の数字も見ておきます。発表ページには、CursorBench 3.2.0 で Fable 5.1 が 73.4%、Fable 5 が 70.5% という数字と、キャッシュ読み取りが4分の1になったことで「典型的な作業でおよそ25%、エージェントとして長く回す作業では最大45%ほど費用が下がる」という記載があります。なお X などで「low の Fable 5.1 が high の Fable 5 を上回り、費用は3分の1」という言い方が流通していますが、この数値は発表ページにも技術資料にも見当たりませんでした。裏が取れていないため、判断の材料には使っていません。
下げてよいかを、自分の作業で確かめる
他人が公開した削減率は、自分の作業に当たるかどうかを教えてくれません。1回ずつ流して見比べるだけでは、たまたま上手くいった回と、作業の種類による差を取り違えます。次の形で組み立てると、社内展開や発注の判断まで持っていけます。
| 決めること | 中身 | 決め方の目安 |
|---|---|---|
| 対象の作業 | 回数の多い作業を3〜5種類。正解が分かっているものを選ぶ | 先月の集計、既に直した不具合、既に書いた仕様の要約など、答え合わせができるもの |
| 回数と条件 | 1種類につき同じ指示を複数回。段階以外の設定を揃える | 1回だけの比較は偶然を拾う。条件をそろえること自体が結果より重要 |
| 記録する項目 | 答えの正しさ、要る情報の欠落、人が直すのにかかった時間、実費(またはトークン数) | 費用だけを見ると、直す時間が増えたぶんが見えない |
| 合格の線 | 下げてよいと判断する条件を、始める前に文章で書く | たとえば「正しさが変わらず、人が直す時間が延びない」 |
| 戻す条件 | 運用に出したあと、どうなったら元の段階に戻すかを先に決める | たとえば「同じ種類の直しが続けて出たら戻す」 |
合格の線と戻す条件を先に書いておくのは、結果が出たあとに線を引き直さないためです。作業の種類ごとに結果が分かれることも珍しくないので、全部を一律に下げるのではなく、下げてよかった作業だけ下げるのが実務的です。
手順2〜4 claude-api スキルの3つのサブコマンド
Anthropic が公開しているスキル集の中に claude-api があり、その定義ファイルに費用と設定を扱う手順が書かれています。Claude Code からは /claude-api cost-optimize のように呼び出します。中身は自動で最適化する魔法ではなく、順番と承認の取り方を決めた作業手順です。いずれもモデルを動かすので、回すこと自体に利用料が出ます。
手順2 cost-optimize。何にいくらかかっているかを調べ、削れる余地を順位付けします。最初の段階(Step 0)で、対象の範囲・落としてはいけない品質の線・現状の数字を決め、利用者の承認を取る。定義ファイルには「モデルを動かす試行はどれも実費が出るので、先に承認を取ること」と書かれています。そのうえでトークンの内訳を作り、削減の手段を並べます。並べ方は決まっていて、品質を落とさずに済むものが先です。
| 順位 | 手段 | 中身 |
|---|---|---|
| 1 | キャッシュを効かせる | 毎回同じ前置きを送る形にして、読み取り価格で数えさせる |
| 2 | 入力の整理 | 毎回送っている指示文・ツールの説明から、要らない記述を落とす |
| 3 | 繰り返しの整理 | 同じ処理を何度も回している箇所、無駄な往復を減らす |
| 4 | 出力の整理 | 返させる形式を絞る。長い文章を返させない |
| 5 | まとめて処理 | 急がない処理をバッチに回し、半額で流す |
| 6以降 | 思考の深さ・モデルの選択・複数モデルの使い分け | 品質と引き換えになるため、必ず測ってから決める |
1から5は品質を落とさずに済む手段、6以降は引き換えが発生する手段として分けられています。提案は1件ずつ承認するか飛ばすかを選ぶ形で、承認しないものは適用されません。「変えるべき点はない」という結論も正当な結果として扱われています。費用の話でいきなりモデルを下げる相談から始めない、という順序がそのまま手順になっている点が使いどころです。
手順3 prompt-audit。指示文・スキル・ツールの説明を読み、古いモデル向けに書かれた記述を洗い出します。対話しない形式で、見つけた箇所(ファイルと行番号、どの書き方が、なぜ今のモデルには古いのか、確信の度合い)を並べた報告と、修正案の差分の2つを出す。差分を当てるのは、明示して頼んだときだけです。
ここが効くのは、何度も書き足したスキルや指示文を抱えている場合です。前のモデルで返答が長すぎたので短くしろと書いた行、喋りすぎを抑えるために黙らせた行。今のモデルでも同じ指示が要るのかは、消してから同じ作業を流して確かめるのが早い。消したせいで要る情報まで落ちることもあるので、判断は1行ずつ結果を見てから決めます。この手の1行は毎回の入力に乗るので、要らないと分かったものを残すと払い続けることになります。
手順4 migrate。古いモデル向けに書いた呼び出しを、新しいモデルへ移す手順です。これも最初に対象の範囲を確認してから編集に入ります。ファイルを対象モデル別に分類し、モデルごとに決まっている非互換の変更を当て、最後に prompt-audit と同じ観点で指示文を見ます。Fable 5.1 なら、道具の呼び出しを強制する指定が使えなくなった点、会話の履歴を後から書き換えるとエラーになる点が該当します。ファイルを直接書き換えるので、実行前に版管理へ記録しておかないと元に戻せません。
公式の移行手順には「既定の high から effort を調整し直すこと」が独立した項目として並んでいます。モデル名を差し替えて動いたから終わり、ではなく、そのあとに深さを測り直すところまでが移行だという書き方です。複数のコーディングエージェントを並行で動かす環境の話はOrca の記事に、外から実行を仕掛ける運用は遠隔で回す記事に書いています。
無料で公開されている道具4本——何を縮めるかで分ける
ここからは Anthropic 以外が公開しているものです。いずれも Fable 5.1 専用ではありませんが、効き方はモデルによって変わり、どのモデルでも同じ削減率が出るとは、どの作者も書いていません。4本を並べると、縮める対象と、導入時に確かめるべき点がそれぞれ違うことが分かります。
| 道具 | 向いている作業 | 入れる前に確かめること | 運用の負担 |
|---|---|---|---|
| caveman | 返答が長く、読むのに時間がかかっている作業 | 同梱のプロキシを使うとやり取りが中継役を通る。どこを経由するかを確認する。スキルだけなら送信先は変わらない | ルール自体が毎ターン 1,000〜1,500 トークンの入力を占める。もともと簡潔なやり取りでは逆に高くつく |
| rtk | テストやビルドの長い出力を毎回そのまま読ませている作業 | 端末の出力を縮めてから渡すので、落ちた行が判断に要るものでないか確かめる。手元で動き、外部には送らない | 対応ツールごとの設定が1か所。外せば元に戻る |
| ponytail | 頼んでいないコードまで書かれてしまう作業 | Claude Code のプラグインとして入る。Node.js が要る。更新を誰が追うかを決めておく | 判断の段取りが増えるぶん、簡単な依頼でも手数が増える |
| codegraph | 毎回同じ大きなソースを読ませている作業 | 手元に索引ファイル(SQLite)を作る。索引の中身はソースの構造なので、置き場所と権限を決めておく | ソースが変われば索引の作り直しが要る。誰がいつ回すかを決める |
caveman は、返答を電報のように短くさせるスキルと、送る文章を圧縮するプロキシ(やり取りのあいだに入って中身を書き換える中継役)の組み合わせで、強さは lite / full / ultra から選びます。作者が載せている表は10件の作業を素の状態と比べたもので、作業ごとの削減率は22%から87%まで開きがあり、その平均が65%。同じ表で出力トークンの平均は 1,214 から 294 です。作者自身の但し書きも明確で、「スキルが短くするのは出力だけで、入力と思考のトークンは変わらない」「スキルのルール自体が毎ターン 1,000〜1,500 トークンの入力を食う」「もともと簡潔なやり取りでは、かえって高くつくことがある」と書かれています。同梱のプロキシ側は別の測定で、54回の実行における入力トークンが合計で33.2%減ったとしています。ライセンスはスキル部分が MIT、エンジンとプロキシは BSL-1.1。
rtk は、シェルコマンドの出力をモデルに渡す前に縮める Rust 製の道具です。git status の長い出力を要約に置き換える、通ったテストを件数だけにまとめる、といった処理をします。対応するコーディング支援ツールは17種類。README の注記は節度があります。表示するトークン数は「バイト数 ÷ 4」の概算であること、端末の出力は入力の一部でしかなく入力は費用の一部でしかないため、最大90%は請求額が90%下がることを意味しないこと。効くかどうかは、自分の使い方で端末の出力がどれだけの割合を占めているかによります。手順2で内訳を見て、そこが大きかった場合に試すのが順当です。ライセンスは Apache-2.0。
ponytail は方向が違い、そもそも書かせるコードを減らします。「これは本当に要るか」「もう同じものが手元にないか」「標準の機能で済まないか」といった判断を7段階で順に踏ませ、最後に必要最小限を書かせる。作者が示す数字の条件は README にはっきり書かれていて、FastAPI と React の題材リポジトリ、12件の作業、Haiku 4.5、n=4 で、コード量54%減・トークン22%減・費用20%減・27%高速。1つの案件での比較であり、そのまま自分の環境に移せる数字ではありません。以前の単発の比較で出た80〜94%減は、比較対象の側に余計な文章が混ざっていた分を含む、という説明まで書かれています。Node.js が要ります。MIT。
codegraph は圧縮ではなく、探し方を変えるものです。コードの構造と呼び出し関係をあらかじめ手元の索引(SQLite というファイル1つで動くデータベース)に保存しておき、codegraph_explore という MCP(AI が外部のデータを直接読み書きするための通信規格)の道具1つで、関係する部分をまとめて返します。grep と読み込みを何往復もする代わりに、1回の問い合わせで済ませる形です。作者の測定は7つの実在リポジトリ、Claude Opus 4.8 を画面なしで動かし、各1問を4回ずつ流した中央値、2026年8月の再測定で、道具の呼び出し88%減・トークン62%減・費用44%減。MIT。
4本とも GitHub のスターは7.0万から13.1万で(2026年9月8日時点)、公開直後の実験ではありません。ただしスターの多さは、自分の環境で費用が下がる証明にはなりません。上の削減率はすべて各リポジトリの作者による主張で、当社が測った値ではなく、測り方も作者ごとに違います。
どれから試すか——当社の見方
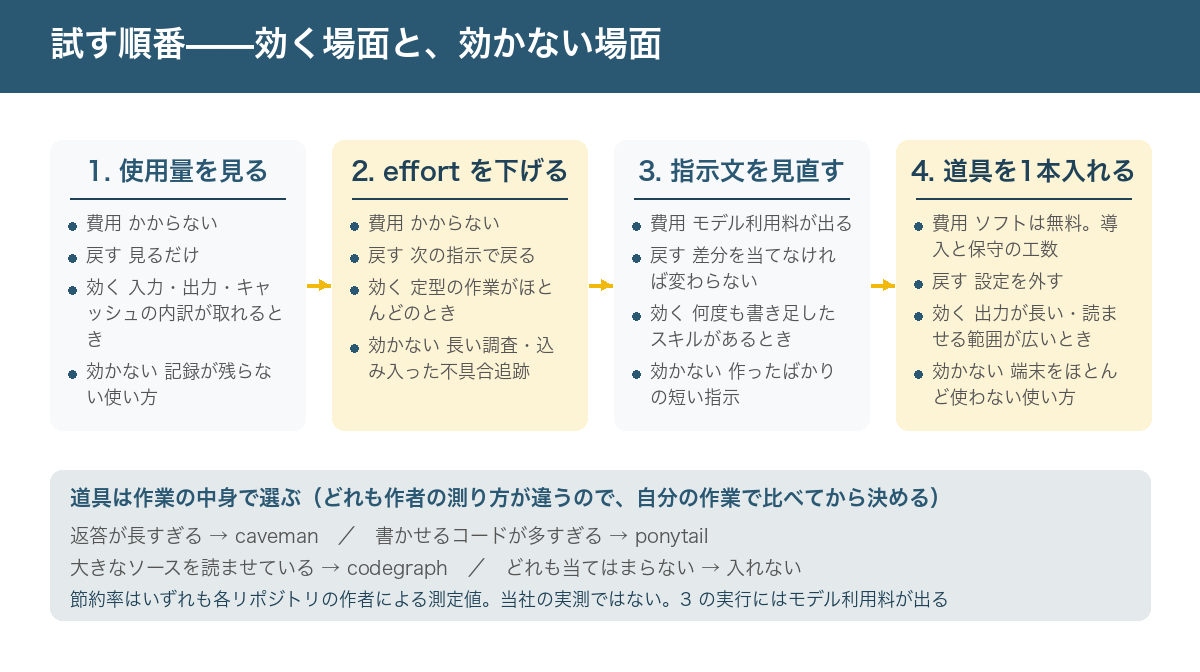
最初にやるのは使用量の内訳を見ることです。ここを飛ばすと、費用が下がったのか上がったのか、どの手が効いたのかが分かりません。内訳が見えたら、増えている場所で打つ手を分けます。出力が大きいなら、部分編集を指示する書き方と effort の見直しが先で、それでも長ければ caveman や ponytail。入力が大きいなら、指示文の点検とキャッシュの当て方が先で、端末の出力が多いなら rtk、読ませるソースが広いなら codegraph。思考の分が大きいなら effort を測り直します。
かかるものを分けておくと判断しやすくなります。設定の変更自体には費用がかかりませんが、点検の手順を回すにはモデル利用料が出ますし、道具を入れれば人の時間がかかります。
| 打つ手 | かかるもの | 戻し方 |
|---|---|---|
| effort を下げる | 設定の変更そのものに費用はかからない | 次の指示で戻る |
| prompt-audit を回す | モデル利用料。読ませる指示文の量だけ入力に乗る | 差分を当てなければ何も変わらない。当てたなら版管理から戻す |
| cost-optimize を回す | モデル利用料。定義ファイルにも「試行はどれも実費」と書かれている | 承認した分だけ適用される |
| migrate を回す | モデル利用料。ファイルを直接書き換える | 実行前に版管理へ記録し、そこから戻す |
| 道具を1本入れる | ソフト自体は無料。導入と保守の工数、送信先や権限を確かめる人の時間 | 設定を外す |
effort を先に触るのは、変更が1行で済み、気に入らなければ次の指示で戻せるからです。ここを飛ばして道具を4本入れると、どれのおかげで何が変わったのかが分からなくなります。指示文の点検を2番目に置くのは、毎回の入力に乗り続けるものが積み上がりやすいからです。ただし消してよいかは、消したあとに同じ作業を流して要る情報が落ちていないかを見てから決めます。
道具を入れるなら rtk が試しやすい方です。手元で動いて外部に送らないこと、設定を外せばすぐ戻ることが理由で、端末の長い出力が入力の大きな部分を占めている場合に効きます。占めていないなら入れても数字は動きません。残りの3本は、作業の形が合致したときだけ入れます。返答が長すぎるなら caveman、頼んでいないコードまで書かれるなら ponytail、毎回同じ大きなソースを読ませているなら codegraph。当てはまらないなら入れないのが正解です。
費用の話を「トークンを減らす」だけで終わらせないことをお勧めします。減らす前に、月にいくらまで出してよいのかと、超えたときに誰がどう気づくのかを決めておく。上限と監視が無い状態でいくら削っても、次に作業が増えた月に同じ驚き方をします。この設計はAPI 費用の見積もりの記事に、モデルの選び分けはモデル比較の記事にまとめました。
まとめ
Fable 5.1 でトークンが増えるのは、文字の数え方が古いモデルより多めに出ること、小さな修正でもファイル全体を書き直しやすいこと、道具を1ターンに1回ずつ呼ぶことがあること、そして使うサービスによっては既定の思考の深さが高いことが重なるためです。どれも公式資料に書かれている性質で、隠れた不具合ではありません。
打つ手は、効く場所ごとに分かれています。思考の深さは effort で、毎回送る文章は prompt-audit で、全体の順位付けは cost-optimize で、古い呼び出しは migrate で。設定を変えること自体に費用はかかりませんが、点検の手順を回す試行にはモデル利用料が出るので、範囲を決めてから流します。そのうえで足りなければ、シェルの出力を縮める、返答を短くする、書かせるコードを減らす、読ませる範囲を絞るという4方向の道具から、自分の作業に当たるものを1本ずつ試す。
どれも「同じ結果に払う額を変える」種類の手段なので、下げてよいかは自分の作業で確かめるほかありません。合格の線と戻す条件を先に決めておけば、他人が公開しているどの節約率よりも確かな判断材料になります。
ここまでの多くは社内で確かめられます。使用量の内訳を出す、effort の段階を変えて同じ作業を回す、指示文を1行ずつ見直す、道具を1本入れて外す。どれも既存の契約と管理画面の範囲でできます。外の手が要るのは、内訳を出す仕組みそのものが無い、対象の作業が多くて社内で比較を設計しきれない、上限と監視を含めた運用の形を決める必要がある、といった場合です。まず社内で試し、詰まった箇所だけ相談する順番をお勧めします。
Claude Code・Claude API の費用を見積もり、上限と監視を設計します
支援の範囲は3つです。使用量の内訳を出す仕組みの整備、代表的な作業で段階を比べる検証の設計と実施、月額の上限と超過時に誰がどう気づくかを決める運用設計。お渡しするのは、内訳を示した現状の資料、比較の結果と合格の線をまとめた検証結果、上限と通知の設定手順の3点です。経理AX・kintone・案件管理システムの刷新・Claude 導入で本番稼働まで伴走した経験をもとに、いまの使用量を見るところから始められます。