Anthropic が 2026 年 9 月 28 日に Claude Sonnet 5.5 を公開しました。6 日前に出た Opus 5.5 に続く、Claude 5.5 世代の 2 つ目のモデルです。価格は Sonnet 5 と同じまま据え置かれ、発表では出力が 30% 以上速くなり、1 つの仕事にかかる費用は最大で 3 割下がるとされています。
今回の判断を難しくしているのは、Sonnet 5.5 のスコアが Opus 5.5 にかなり近いことです。知的労働を測る GDPval-AA では 2 点差しかなく、コマンド操作を伴うコーディングの Terminal-Bench 4.0 では Opus 5.5 を上回っています。それでいて入力と出力の単価は Opus 5.5 の半分です。Sonnet 5 から上げるべきかという疑問に加えて、Opus 5.5 を使う理由が残るのかという疑問も出てきます。
この記事では、Anthropic の発表ページと開発者向けドキュメント、Claude Code のドキュメントを直接読み、そこに書かれている数字と説明だけで、2 つの疑問に答えます。
Sonnet 5 を使っているなら、切り替えてよいモデルです。単価は変わらず、同じ仕事に使うトークンが減るので、多くの場合は安く、速くなります。Opus 5.5 との使い分けは、「やることがはっきり決まっている作業は Sonnet 5.5、判断を積み重ねて進める作業は Opus 5.5」が出発点です。スコアの差は小さくても、Anthropic 自身が「長く判断を続ける自由度の高い仕事では Opus 5.5 がはっきり強い」と書いています。API で使っている場合は、Sonnet 5 で通っていた書き方のうち 5 つがエラーになるので、切り替える前にコードを確認してください。
この記事の要約
この記事の調べ方
価格・性能・顧客の実測値は Anthropic の発表ページを、移行時の変更点・既定値・提供範囲は Claude の開発者向けドキュメントと Claude Code のドキュメントを、2026 年 10 月 2 日に開いて確認しました。ベンチマークの表は、列の並び(Sonnet 5.5 / Sonnet 5 / Opus 5.5 / GPT-6 Sol)と脚注を読み直したうえで転記しています。報道は根拠に使っていません。
切り替えるかどうか。答えは「切り替えてよい、ただし考える深さを測り直す」
Sonnet 5 から上げることに、ほとんどためらう理由はありません。開発者向けドキュメントは、Sonnet 5.5 の料金をキャッシュやバッチ処理の割引も含めて Sonnet 5 と同じだと明記しています。そのうえで発表ページは、同じ仕事をこなすのに必要なトークンがずっと少ないと書いています。単価が同じで使う量が減るので、請求額は下がる方向に動きます。
切り替える前に 1 つだけ決め直すことがあります。です。ドキュメントには、Sonnet 5.5 では effort の段階が調整し直されており、同じ段階でも Sonnet 5 と同じ量だけ考えるわけではない、と書かれています。Sonnet 5 で使っていた設定をそのまま持ち込まず、自分の業務で段階ごとに結果を測り直すよう求めています。
Opus 5.5 から下げるかどうかは、作業の性格で決まります。ここは後半で詳しく書きますが、Anthropic は Sonnet 5.5 を「範囲がはっきりした日々の作業、不具合の修正、資料や表計算の作成」に強いモデルとし、Opus 5.5 を「慎重な判断が要る複雑な仕事」向けとしています。
- Sonnet 5 を API で使っている。モデル名を
claude-sonnet-5-5に変え、後半で説明する 5 つの書き方を直し、effort を段階ごとに試し直してください。 - Claude Code で sonnet を指定している。Anthropic の API 経由なら、バージョン 2.1.284 以降で sonnet が Sonnet 5.5 を指すようになっています。effort の既定は medium です。
- Opus 5.5 を使っている。範囲の決まった作業から順に Sonnet 5.5 で試し、足りるなら入力と出力の費用は半分になります。キャッシュの読み出しは両者とも同じ単価です。
- Haiku を大量に回している。Haiku 5.5 が数週間のうちに出ると予告されているので、その発表を待ってから決めても遅くありません。
価格は据え置き。下がるのは 1 つの仕事に使うトークンの量
まず単価を並べます。すべて 100 万あたりの米ドル建てで、Claude の開発者向けドキュメントの価格表から取っています。
| 項目 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| 入力 | $2 | $2 | $4 |
| 出力 | $10 | $10 | $20 |
| の書き込み(5 分保持) | $2.50 | $2.50 | $5 |
| キャッシュの読み出し | $0.20 | $0.20 | $0.20 |
| API での既定の effort | high | — | medium |
Sonnet 5 との比較では、すべての欄が同じです。「—」は今回確認していない欄です。費用が下がるのは単価ではなく、使う量のほうだということが表からも分かります。
Opus 5.5 との比較で見落としやすいのは、キャッシュの読み出しです。Opus 5.5 はキャッシュの読み出しを入力単価の 5% に設定しているため、Sonnet 5.5 と同じ $0.20 になっています。入力と出力は Sonnet 5.5 が半額でも、同じ資料やコードを何十回も読み直す使い方では、請求額の大きな部分を占める読み出しの単価に差がありません。Claude Code のように読み出しの多い使い方では、Opus 5.5 との費用差は単価表の見た目ほど開かない場合があります。Opus 5.5 の価格の仕組みはOpus 5.5 の解説記事に書いています。
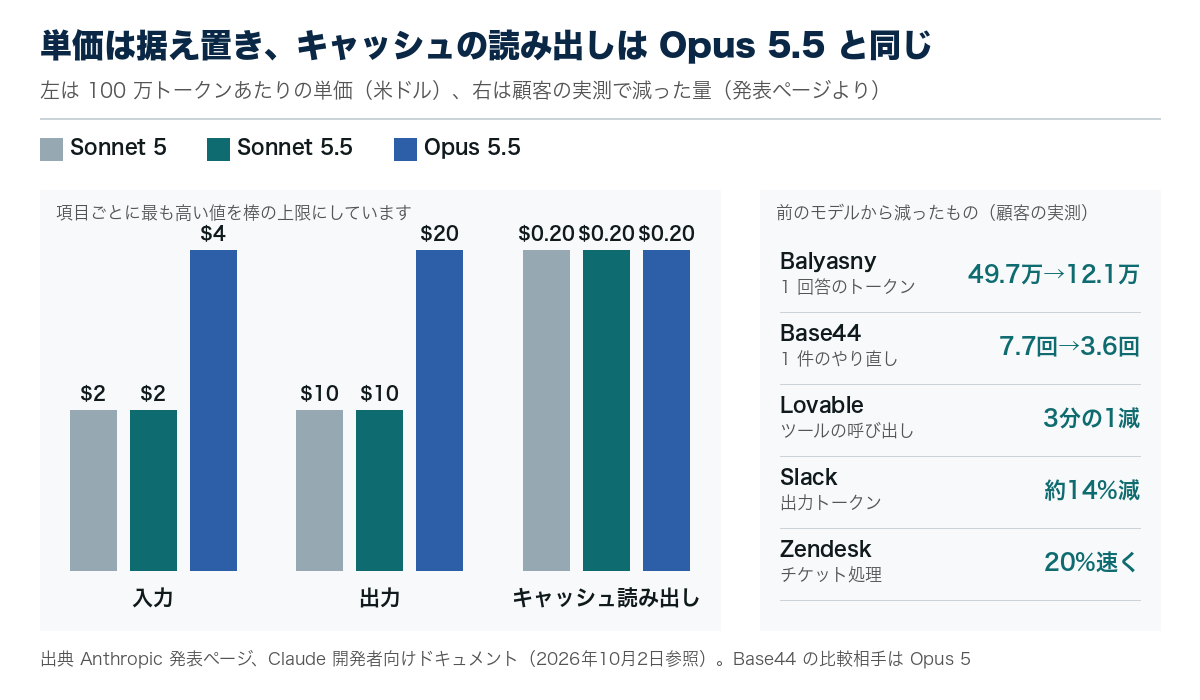
では、使う量はどれくらい減るのか。発表ページに載っている顧客の実測から、量や速さに触れているものを並べます。
| 顧客 | 発表ページに書かれている実測 |
|---|---|
| Balyasny Asset Management | 金融の課題 2,441 件で Sonnet 5 を上回り、1 回答あたりのトークンは約 12 万 1 千。Sonnet 5 は約 49 万 7 千だった。 |
| Base44 | 実際のアプリ制作 118 件で Opus 5 と同じ評価のアプリを作り、1 件あたりのやり直しは平均 3.6 回。Opus 5 は 7.7 回だった。 |
| Lovable | コーディングの評価で、ツールを呼ぶ回数が 3 分の 1 減り、シェルの実行は約半分になった |
| Box | 前のモデルより正確で、2.4 倍速く、使うトークンの合計は 12% 少なかった |
| Slack | プロンプトを変えずに、ほぼすべての評価で Sonnet 5 を上回り、手順が少なく、出力トークンは約 14% 少なかった |
| Zendesk | 実際のサポート対応の事例で、チケットの処理が 20% 速くなった |
顧客の報告に共通するのは、回数の減少です。ツールを呼ぶ回数、やり直しの回数、シェルを実行する回数が減っています。発表ページも、初期の利用者がツールの呼び出しを Sonnet 5 よりまとめて行うようになり、手順が減って費用が下がったと書いています。1 回ごとに賢くなったというより、同じ仕事を少ない往復で終えるようになった、と読むのが実態に近いはずです。
発表ページの費用対効果のグラフにも、同じ傾向が出ています。Terminal-Bench 4.0 では、Claude のアプリの既定である medium で動かした Sonnet 5.5 が、Sonnet 5 の最高スコアを大きく上回り、1 課題あたりの費用は 10 分の 1 未満でした。FrontierCode では、同じ high で比べて Sonnet 5 より 10 ポイント高く、1 課題あたりの費用は約 15 分の 1 だったとされています。
ベンチマークは Opus 5.5 に迫る。ただし作り手は Opus 5.5 を上に置いている
発表ページには 8 項目のベンチマークが載っています。列の並び(Sonnet 5.5 / Sonnet 5 / Opus 5.5 / GPT-6 Sol)を確認したうえで、Claude の 3 モデルを転記します。GDPval-AA と AA-Briefcase は点数、それ以外は正答率(%)です。Terminal-Bench はコマンド操作を伴うコーディング、FrontierCode は書いたコードがそのまま取り込まれるか、CursorBench は実際の開発作業から作った課題、GDPval-AA と AA-Briefcase は知的労働、OSWorld はパソコン操作、Chartography は図表の読み取りを測るものです。
| ベンチマーク | Sonnet 5.5 | Sonnet 5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6 | 10.3 | 66.4(xhigh) |
| FrontierCode 1.1 | 52.1(xhigh)/46.2(max) | 42.4 | 54.4 |
| CursorBench 4.0 | 55.5 | 34.1 | 57.8 |
| GDPval-AA v2.1(点) | 1844 | 1449 | 1846 |
| AA-Briefcase v1.1(点) | 1811 | 1359 | 1822 |
| Humanity's Last Exam(ツールあり) | 64.5 | 54.9 | 67.7 |
| OSWorld 2.1(部分点) | 80.1 | 57.0 | 81.8 |
| Chartography(ツールなし) | 61.6 | 15.6 | 64.4 |
Sonnet 5 からの伸びは大きく、Terminal-Bench 4.0 は 10.3% から 70.6% に、Chartography は 15.6% から 61.6% に上がっています。Opus 5.5 と比べると、Terminal-Bench 4.0 だけは Sonnet 5.5 が上回り、ほかの 7 項目は Opus 5.5 がわずかに上です。GDPval-AA の差は 2 点、CursorBench は 2.3 ポイントしかありません。
表の注記には、読み方に関わることがいくつか書かれています。Terminal-Bench 4.0 の Opus 5.5 の値は xhigh で測ったものです。FrontierCode の Sonnet 5.5 は、最も深い max のほうが xhigh より低い点になりました。max では、作業を多くのに分けてレビューする機能を動かす場面が増え、時間切れや頼まれていない修正につながったため、と説明されています。深く考えさせれば必ず点が上がるわけではない、という一例です。
GDPval-AA と AA-Briefcase は、測定した Artificial Analysis が公開前の環境で測っており、構造化出力(決まった形式で答えさせる機能)に不具合があったと注記されています。影響は小さく、Sonnet 5.5 の点はむしろ低めに出ている可能性があり、不具合はすでに直っているとのことです。同じ表には OpenAI の GPT-6 Sol の値も 4 項目で載っています(FrontierCode 49.3、GDPval-AA 1487、AA-Briefcase 1483、Chartography 53.6)。この 4 項目では、どれも Sonnet 5.5 のほうが上です。
そのうえで、Anthropic は表の前に次のように書いています。
ベンチマークのスコアは、モデルの能力の一面しか捉えていない。私たち自身の検証でも、外部の検証者の評価でも、長く判断を続ける必要がある自由度の高い複雑な仕事では、Opus 5.5 がはっきりと強いままだ。
Anthropic「Claude Sonnet 5.5」発表ページより(原文は英語、筆者訳。2026 年 10 月 2 日参照)
Opus 5.5 の発表でも、Anthropic は Opus 5.5 と Fable 5.1 の差はスコアが示すより小さいと書いていました。今回は逆向きで、スコアの差が小さくても実際の差はある、という書き方です。どちらも、表の数字だけで選ばず、自分の仕事で試すべきだという同じ立場から出ています。はてなベースでも、公表値は試す候補を選ぶ材料にとどめ、決めるのは自分たちの業務で比べた結果にしています。
Opus 5.5 との使い分けは、作業の範囲が決まっているかで分ける
では、どこで線を引くか。Anthropic の開発者向けドキュメントにある「モデルの選び方」の表では、次のように分けています。
| 必要なもの | 勧められているモデル | 例として挙がっている用途 |
|---|---|---|
| 日々のコーディング・エージェント・業務での速さと能力 | Sonnet 5.5 | コードの生成、データ分析、文章などの作成、画像の読み取り、ツールを使うエージェント |
| 複雑なエージェントのコーディングと企業の業務 | Opus 5.5 | 何時間も自律で進めるコーディング、大規模な作り直し、複雑なシステム設計、画像を多く扱う業務、パソコン操作 |
| 利用できる中で最も高い能力 | Fable 5.1 | 何時間も続くエージェントの作業、何段階もの調査、分析を仕上がった文書や資料まで持っていく作業 |
発表ページの言い方に直すと、Sonnet 5.5 は「範囲がはっきりした日々の作業、不具合の修正、資料・スライド・表計算の作成」、Opus 5.5 は「慎重な判断が要る複雑な仕事」です。はてなベースでは、この線を次の 2 つの問いに置き換えて判断するのが分かりやすいと考えています。
- 作業の終わりが先に決まっているか。直す不具合が特定されている、作る資料の型が決まっている、チェックの項目が決まっている、といった作業は Sonnet 5.5 から試す。
- 途中で判断を積み重ねる必要があるか。要件を整理しながら設計を決める、原因の分からない障害を調べる、複数の資料から結論を組み立てる、といった作業は Opus 5.5 から試す。
経理や総務の業務に当てはめると、決まった様式の書類の作成、請求書と入金の突き合わせ、定型の集計は前者に近く、業務フローを見直す設計や、例外が多い処理のルールづくりは後者に近いはずです。ただ、これは作業の性格からの見立てで、どちらで足りるかは実際に試さないと分かりません。
2 つを組み合わせる使い方もあります。発表ページに載っている声の中には、「Opus 5.5 がゲームの設計と全体の骨組みを決めるなら、その実装は Sonnet 5.5 に任せられる」というものがあります。ドキュメントも、安いモデルに作業の大半を任せ、難しい判断だけを上位のモデルに回す組み合わせ方を紹介しています。Claude Code の opusplan(計画は Opus、実行は Sonnet で行う設定)も同じ考え方で、Anthropic の API 経由なら実行役が Sonnet 5.5 になりました。
effort の始め方
Sonnet 5.5 向けのプロンプトの手引きは、API では既定の high から始めることを基本にしつつ、範囲のはっきりしたエージェントのコーディングや複数のツールを使う作業は medium から、チャットのように待ち時間を短くしたい用途は medium か low から始めるよう勧めています。xhigh と max は、品質が上がることを測って確かめた作業だけに使うよう書かれています。low では、変更を確かめる手順を飛ばして完了と報告することがあるとも注意されています。
Claude Code では sonnet の指す先が変わり、effort の既定は medium
Claude Code のドキュメントでは、Anthropic の API 経由で使っている場合、/model sonnet などで sonnet を選ぶと Sonnet 5.5 が使われます。Sonnet 5.5 にはバージョン 2.1.284 以降が必要です。何も指定しなかったときの既定のモデルは、Pro・Max・Team・Enterprise の各プランと API のどれでも Opus 5.5 のままです。Amazon Bedrock、Google Cloud、Microsoft Foundry、Claude Platform on AWS 経由では、sonnet はまだ以前の Sonnet を指しています。
気をつけたいのは effort の既定値です。API での Sonnet 5.5 の既定は high ですが、Claude Code と Claude のアプリでは medium が既定です。発表ページにも、Claude Code とアプリは medium、Claude の開発者向けの環境は high が既定だと書かれています。同じモデルでも、使う場所によって考える深さの初期値が違います。
Opus 5.5 のときと同じく、ユーザー設定ファイルの一番上の階層に書いた effort の既定値(effortLevel)は、Sonnet 5.5 には効きません。Sonnet 5.5 は自分の既定から始まるので、深さを変えたいときは /effort か /model の画面で選び直します。考える処理(thinking)を切ることもできず、切り替えの設定や環境変数を入れても効果はありません。
もう 1 つ、複数のアカウントを使い分けている人向けの変更があります。Sonnet 5.5 が考えた内容は、それを作ったアカウント(と連携したアカウント)の中でしか使えなくなりました。発表ページは、Claude Code で作業の途中にアカウントを切り替えると影響を受けると書いています。Claude Code の基本はClaude Code の使い方ガイドに、利用上限については利用上限の解説記事にまとめています。
API で使っている場合、Sonnet 5 で通っていた書き方のうち 5 つがエラーになる
ここからは、自社のシステムや業務の仕組みに Claude の API を組み込んでいる方向けの内容です。Claude のアプリや Claude Code だけを使っている方は、次の節まで飛ばして構いません。
開発者向けドキュメントは、Sonnet 5 で動いていたコードに影響する変更を 5 つ挙げています。該当する書き方が残ったままモデル名だけを差し替えると、その呼び出しがエラー(HTTP 400)で止まります。
| 変わること | Sonnet 5.5 でどうなるか | 直し方 |
|---|---|---|
| 考える処理を切る指定(disabled) | エラーになる | between_tools(最初に考えず、ツールの合間だけ書く設定)に替える。使えるのは effort が high 以下のとき。 |
| 特定のツールを必ず使わせる指定(tool_choice の any と tool) | エラーになる。トークン数を数える窓口でも同じ。 | auto に戻し、厳密なツール使用か構造化出力を使う。ツールを使う場面はプロンプトに書く。 |
| 会話の途中で指示文やツール定義や過去の発言を書き換える | 2026 年 8 月 31 日以降に作ったアカウントでは、書き換え後に過去の考えた内容を送り直すとエラーになる | 会話は付け足すだけにし、指示の変更は会話途中のシステムメッセージで行う |
| 旧版のパソコン操作ツール(computer_20251124) | Claude の API と Google Cloud ではエラーになる。Amazon Bedrock では動く。 | 新しいツール一式(computer_toolset_20260801)に移す |
| 相談役ツール(advisor)で Opus 4.8・Opus 4.7・Sonnet 5 を相談役にする | エラーになる | Opus 5.5・Opus 5・Fable 5.1 など、Sonnet 5.5 が受け付ける相談役に替える |
1 つ目は Opus 5.5 と扱いが違います。Opus 5.5 では考える処理を切る方法そのものがありませんが、Sonnet 5.5 には between_tools という一番軽い設定が用意されました。最初に考えずに答え始め、ツールを呼ぶ合間にだけ短いメモを書く動きになります。ただし xhigh と max では使えず、会話の途中で effort を変えることもできません。ツールを使わない依頼でこの設定にすると、考えずに答えるので、計算や判断を含む作業では精度が下がると手引きに書かれています。
エラーにはならないものの、見た目が変わる点もあります。ツールを呼ぶ合間にモデルが書く途中経過が、通常の本文ではなく、考えた内容の枠で返ってくるようになりました。既定の設定ではその中身が空なので、途中経過を利用者の画面に流している仕組みでは、ツールを呼ぶ間だけ表示が止まったように見えます。また、temperature などの出力のばらつきを決める値を既定以外にするとエラーになる点、キャッシュできる最小の長さが 512 トークンに下がった点もドキュメントに書かれています。
Claude Code には、この書き換えをまとめて行う /claude-api migrate というコマンドが用意されています。モデル名の差し替え、エラーになる指定の書き換え、effort の調整までを行い、手で確かめる項目の一覧を出してくれます。
Sonnet で初めて、サイバーセキュリティの安全対策が付いた
Sonnet 5.5 は、サイバーセキュリティの能力が Opus 5 並みに上がったため、Sonnet として初めて、上位モデルと同じような安全対策と代替の仕組みを付けて公開されました。普段の開発で不具合を見つけて直す作業は対象外で、危険度の高いセキュリティの作業は Sonnet 5 に回される、と発表ページは書いています。
API で使う場合、断られた依頼は停止理由が refusal の通常の応答として返ってきます。サーバー側で自動的に回し直す設定(試験提供)を入れると、サイバーセキュリティと、競合する AI モデルの開発に関わる依頼は Sonnet 5 で答え直されます。生物学の分野の安全対策は Sonnet 5 と同じで、こちらは回し直しの対象外です。Claude Code では、生物学の分野で止められた依頼はそのまま断りとして終わります。
もう 1 つ、Sonnet として初めて、考えた内容を本文に書き出させようとする依頼を断る仕組みが入りました。プロンプトに「考えた過程も回答に含めて」と書いている場合は、その指示を外し、必要なら考えた内容の要約を別の形で受け取るよう手引きが勧めています。
使える場所と、提供の期間
| 項目 | 内容 |
|---|---|
| 提供先 | Claude の API、Amazon Bedrock、Claude Platform on AWS、Google Cloud、Microsoft Foundry |
| 入力できる量と出力の上限 | 100 万トークンまで入力でき、1 回の出力は 12 万 8,000 トークンまで。バッチ処理では試験提供で 30 万トークンまで。 |
| 知識の範囲 | 2026 年 6 月まで。Opus 5.5・Fable 5.1 と同じ。 |
| Opus 5.5・Sonnet 5 と同じく使える | |
| 提供終了 | 2027 年 9 月 28 日より前には終了しない(Claude の API、Claude Platform on AWS、Microsoft Foundry での約束。Amazon Bedrock と Google Cloud は各社が日付を決める) |
会社で使うときに確認されやすいのは、送った内容を保存させない扱いと、提供の期間です。どちらも Opus 5.5 と同じ条件で、Sonnet 5.5 だけ制約が多いということはありません。各プランの料金と上限はClaude の料金ガイド、モデルごとの違いはClaude のモデル比較ガイドで整理しています。上位の Fable 5.1 についてはFable 5.1 の解説記事をご覧ください。
今後の予定として、量の多い用途や費用を抑えたい用途向けの Haiku 5.5 が、数週間のうちに Claude 5.5 世代に加わると発表されています。
明日から変えること
最後に、立場ごとにやることを並べます。
- Sonnet 5 を API で使っている開発担当の人は、考える処理を切る指定、ツールを強制する指定、会話の書き換え、旧版のパソコン操作ツール、相談役ツールの組み合わせの 5 つがコードに無いかを検索してください。そのうえでモデル名を変え、effort を段階ごとに測り直します。
- Claude Code で sonnet を使っている人は、普段の作業を 1 つ選び、Sonnet 5.5 の medium で出来を確かめてください。物足りなければ
/effortで上げます。 - Opus 5.5 を使っている人は、範囲の決まった作業を 1 つ選んで Sonnet 5.5 で試してください。足りるなら入力と出力の費用は半分です。キャッシュの読み出しが多い使い方では、差がそれより小さくなる点も試算に入れます。
- 費用を管理している人は、単価ではなく使う量が下がるモデルだという点を押さえ、切り替え前後の 1 週間で請求額を比べてください
スコアの表は、どのモデルを試すかを決める材料にはなります。ただ、Anthropic 自身が Opus 5.5 を上に置いているとおり、Sonnet 5.5 で足りるかどうかは、自分の業務で試さないと分かりません。単価が据え置かれた今回は、試すための追加の費用がほとんどかからないのが救いです。
Claude を業務に組み込むところからご一緒します
たとえば「Opus と Sonnet のどちらを使うか、業務ごとに線を引きたい」「API のモデルを切り替えたいが、どこがエラーになるか洗い出せていない」といった場面で、既存の業務フローへの AI エージェントの組み込み設計と実装、AI が使えるように社内に散らばったデータを整える作業、社外にデータを出せない会社向けのオンプレミス環境での生成 AI 導入までご支援しています。