アンケートや問い合わせの記録を集めても、集計だけでは改善する箇所が決まりません。VoC分析では、顧客が何に困り、何を求めているのかを整理し、商品や対応の変更につなげます。AIは自由記述の分類や要約を補助できます。
VoC分析とは — 「顧客の声を意思決定に変えるプロセス」
VoC(Voice of Customer = お客様の声)分析 とは、アンケート・問い合わせ・SNS投稿・レビューサイトのコメントなど、企業が日々受け取る顧客の生の声を集めて分析し、商品開発や営業戦略・顧客対応の改善に活かす一連のプロセスを指します。
顧客満足度調査もVoCを集める方法の1つです。点数の集計に加え、自由記述や会話から不満の理由や要望を整理し、購入・解約などの行動データと合わせて検討します。VoC分析を定性データだけに限定する必要はありません。
📖 用語補足:CX / NPS / CSAT CX(顧客体験)は、購入前から購入後までに顧客が企業との接点で得る体験を指します。NPSは推奨意向を0〜10点で聞き、全回答者に占める推奨者(9〜10点)の割合から批判者(0〜6点)の割合を引きます。7〜8点は中立者で、スコアの範囲は−100〜100です。CSATは、問い合わせ対応など個別の体験への満足度を測る指標です。自由記述と合わせると、点数の背景を検討できます。
なぜ今、VoC分析が再注目されているのか
VoCは1990年代の研究でも扱われてきた考え方です。現在は、LLM(大規模言語モデル)によって、自由記述の分類や要約を補助する方法が増えています。以前からあるルールベースの分類や機械学習との違いは、自社のデータで比較します。
GPT、Claude、GeminiなどのLLMは、自由記述を読み、テーマ案や要約を出せます。1万件を扱う場合は、文章量に応じた分割、処理漏れの確認、分類の照合が必要です。所要時間と費用は、モデル、文章量、分類基準、検証範囲を決めて見積もります。
📖 用語補足:LLMとは? LLM(Large Language Model) は、大量の文章を学習して人間の言葉を理解・生成できる AI モデル。ChatGPT や Claude の中身はこの LLM。VoC 分析の文脈では「文章を読んで意味を取り、分類できる AI」と理解すれば十分です。
VoCのデータソース — 社内にすでにある『声』6種
社内のアンケート、問い合わせ、通話記録など、利用目的と取り出し方法を確認できるデータから探します。候補には次の6種類があります。
| ① 顧客アンケート(自由記述欄) | 「ご意見・ご感想をお聞かせください」欄 | ★★★ 高(テキスト形式で取り出しやすい) |
| ② NPSコメント | 推奨度の理由を聞く自由記述 | ★★★ 高(短文で構造化しやすい) |
| ③ コールセンターログ | 通話の文字起こし or オペレーターメモ | ★★ 中(音声認識/個人情報の扱い注意) |
| ④ チャットサポートログ | Webチャット・LINE・メールの問い合わせ | ★★★ 高(最初からテキスト) |
| ⑤ レビューサイト | Google/App Store/Amazon/食べログ等 | ★★ 中(スクレイピング規約・著作権注意) |
| ⑥ SNS投稿 | X/Instagram/TikTok の自社言及 | ★ 低(ノイズが多く、文脈把握が難しい) |
初めて試すなら、利用目的と管理者が明確な社内データが候補になります。レビューサイトやSNSの投稿を使う場合は、取得方法、サービスの利用条件、個人情報の扱いを確認します。社内データでも同じ確認が必要です。
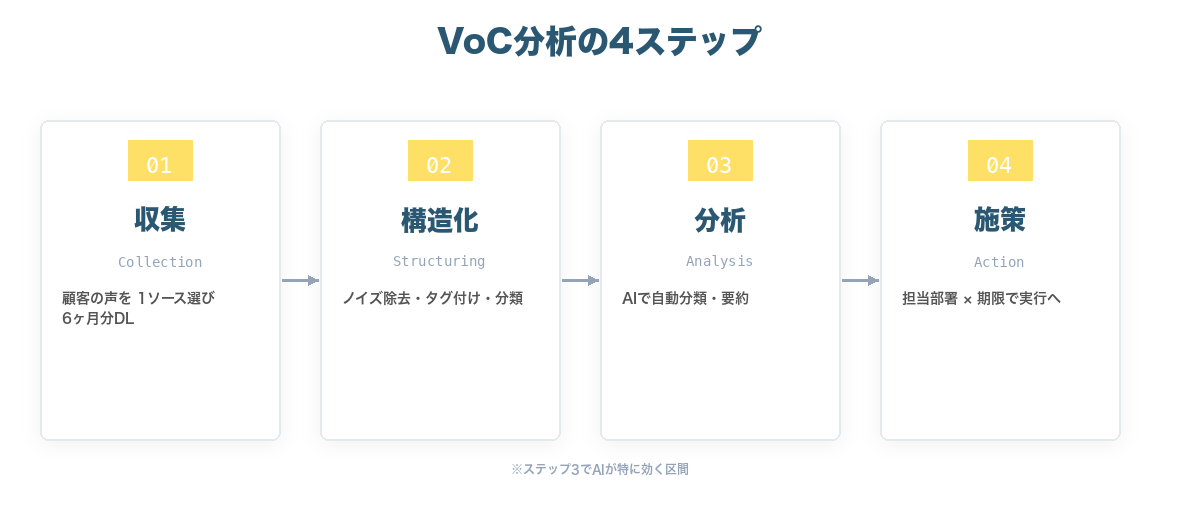
VoC分析の4ステップ — 収集 → 構造化 → 分析 → 施策
最初に、何の判断に使うかを決めます。そのうえで収集、整理、分析、施策の順に進め、結果を見ながら分類基準や対象データを見直します。
ステップ1:収集(Collection)
最初は1つのデータソースを選び、たとえば過去6か月〜1年の記録をCSVなどで取り出します。自由記述500件、通話記録1,000件といった規模は試行の例です。十分な件数は、対象顧客、扱うテーマの種類、珍しい重大事象も探すかによって変わります。
ステップ2:構造化(Structuring)
個人情報を必要に応じてマスキングし、形式の揺れや重複を整理します。原文を保持したうえで、「不満」「賞賛」「要望」「質問」などのタグと、商品名・サービス名を付けます。絵文字や繰り返しも感情や切迫度を示すことがあるため、一律に削りません。まず100件程度で分類案を試し、未分類や複数テーマの扱いを決めます。
📖 用語補足:データクレンジング データクレンジングは、誤りや重複を点検し、分析で扱える形式に整える作業です。VoCでは個人情報のマスキングや改行形式の統一などを行います。欠損や絵文字を除く場合は、分析に必要な意味まで失わないか確認し、処理の記録を残します。
ステップ3:分析(Analysis)
LLMには、テーマ案と各コメントの分類を、元のコメントIDを付けて出力させます。代表コメントは原文から引用し、件数は分類結果をプログラムや表計算で集計します。人が抽出サンプルを照合し、分類の漏れ、複数テーマ、要約の誤りを点検します。一度読めば正確さが保証されるわけではありません。
📖 用語補足:クラスタリングとハルシネーション クラスタリング(Clustering):似たもの同士を自動でグループにまとめる手法。「価格への不満」「使い方がわからない」「サポートが遅い」のように、似た声を1つの塊にする。/ハルシネーション(Hallucination):LLM が事実に基づかない情報を、もっともらしく出力してしまう現象。「お客様からこんな声がありました」と AI が言っても、実際にはそんなコメントは存在しないことがある。必ず原文と照合するのが鉄則。
ステップ4:施策接続(Action)
分析後は、テーマごとに担当部署、期限、変更内容、効果の確認方法を決めます。1枚のシートに記録すると、誰が対応するのかを追いやすくなります。
従来手法 vs AI活用 — 何が変わったか
手作業とAIを比較する際の確認項目です。以下は一般的な見積もり条件の違いで、効果や費用を保証する数値ではありません。
| 1万件の自由記述を分類する時間 | 分類基準、文章量、確認範囲で見積もる | 実行時間に加え、前処理・照合・修正時間を含める |
| コスト | 調査設計・分析・報告の業務範囲に依存 | モデル利用料、実装・検証・運用の人件費を含める |
| 分類の粒度 | 分類目的に合わせて設計 | 細分化できるが、精度と再現性を検証 |
| 再分析 | 再集計できる範囲は契約と納品データによる | 再実行し、変更前後の分類差を確認 |
| 感情の判定 | 基準を決めて判定者間の一致を確認 | 自動判定を基準データと照合 |
AIで短縮できるのは主に読み取りや分類の一部です。分類基準の設計と結果の検証を含めた総工数で比較します。再現性を確かめるには、モデルのバージョン、プロンプト、設定、分類基準を記録します。
VoC分析で確認したい4つの点
AIの出力を使う際も、回答者の偏り、優先順位の基準、施策の担当、原文との一致を確認します。
落とし穴①:声の大きい少数派バイアス
自由記述やレビューに回答する人は、回答しない人と意見が異なる場合があります。強い不満を持つ人が多くなるかどうかも、収集方法によります。回答率、顧客属性、購入・解約状況を確認し、集まった声を顧客全体の割合と同一視しないようにします。
落とし穴②:感情の強さだけで優先順位を決める
感情の強さと改善の優先順位は分けて考えます。件数と影響範囲に加え、被害の重大さ、緊急性、対応費用を確認します。安全性や個人情報の問題は、1件でも優先対応が必要になり得ます。AIの感情スコアだけで順位を決めません。
落とし穴③:分析が「レポートで終わる」
分析結果を施策に使うには、担当者と対応後の確認方法を決めておきます。分類の正確さを点検しながら、実行できる変更を選びます。
落とし穴④:AI幻覚を信じ込む
LLMが「顧客の25%が解約を検討」と出力したら、対象件数、分母、分類結果を元データと照合します。原文にない内容が見つかったら修正し、同じ種類の誤りがほかにもないか確認します。
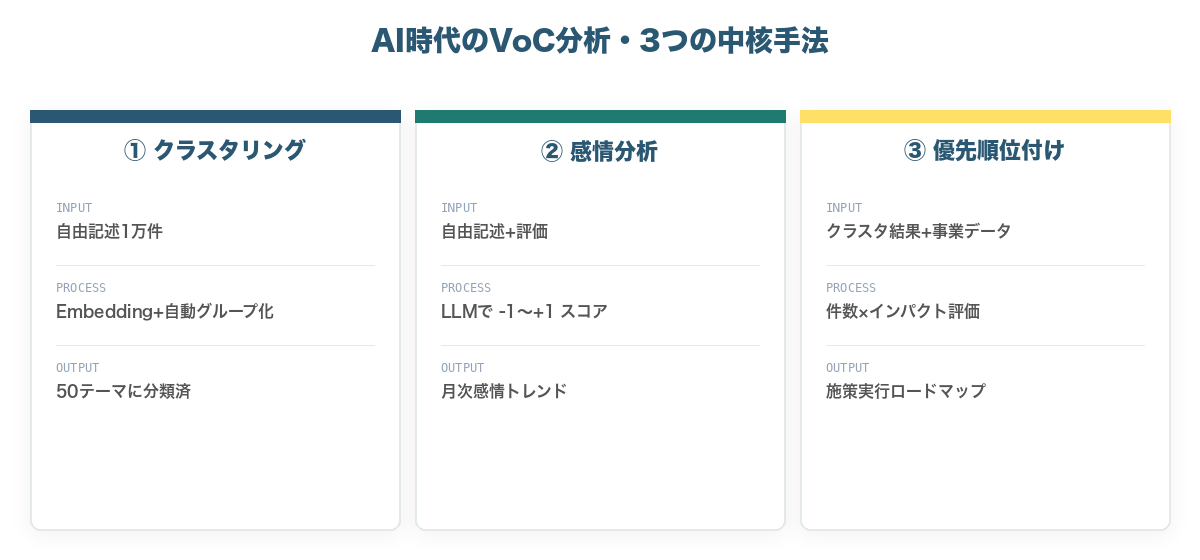
AI時代のVoC分析実践 — 3つの中核手法
AIを使う方法には、似た声の分類、感情表現の判定、優先順位を考えるための材料整理があります。
手法①:クラスタリング(自動グルーピング)
意味の似た声を、自動で同じグループに集める手法。たとえば「価格が高い」「もう少し安くなれば」「コスパが悪い」は、表現は違っても同じ「価格懸念」クラスタとしてまとめられます。技術的にはEmbedding(エンベディング = 文章を数値ベクトルに変換する技術)を使い、ベクトル空間上で近い文同士をくっつけます。
手法②:感情分析(Sentiment Analysis)
感情分析は、文の肯定的・否定的・中立的な表現を分類したり、程度をスコアにしたりする方法です。LLMに−1〜1で採点させることもできますが、その値は顧客満足度の実測値ではありません。月次比較では同じ基準とモデルを使い、回答者の構成やデータソースの変化を確認します。前後差だけでリニューアルの効果とも断定できません。
手法③:件数と影響に基づく優先順位付け
テーマごとの件数と事業への影響を比較します。解約や利用停止との関係、問題の重大さ、対応費用を確認し、担当者が優先順位を決めます。AIには比較材料の整理を補助させます。
📖 用語補足:Embedding と コンジョイント分析 Embeddingは、文章などを数値ベクトルに変換する技術です。意味の近さを表せるかはモデルとデータによるため、分類結果を原文で確認します。コンジョイント分析は、属性を組み合わせた案への選好から属性の効用などを推定する調査手法です。この記事の「件数と影響による優先順位付け」は、コンジョイント分析には当たりません。
はてなベースのVoC分析支援 — 事例とアプローチ
はてなベースでは、VoC分析の対象データと利用目的を確認し、分類・集計から社内運用までの支援内容をご相談いただけます。
- スピード重視のスポット分析 — 自由記述 1,000〜10,000 件を 1〜2 週間で要約・分類・施策提案までワンセットで納品
- 継続運用のためのテンプレ整備 — クライアント社内でも回るよう、プロンプト・分析ワークフロー・レポート雛形を整備して引き渡し
- ガバナンス対応 — 顧客情報の扱いに敏感な業界向けに、契約型クラウドサービス(Claude Enterprise等)や、自社環境で運用するモデル(Llama等)での実装を選択肢として提示
- 部門連携設計 — 分析結果を CS / マーケ / プロダクトに渡す業務フローの設計まで一緒に作り込む(「分析だけ」で終わらせない)
「アンケートが溜まっているが、何から始めればいいかわからない」「コールセンターのログを活用したいが、個人情報の扱いが心配」——そんな状態でも、まずは現状の声の在庫を棚卸しするところから一緒に着手します。