Graphify の紹介記事を読むと、コードをにすると Claude Code のが大きく減る、と書いてあります。読んで最初に浮かぶ疑問は使い方です。自分でグラフの画面を眺めてコードを把握する道具なのか、それとも一度入れておけば、実装を頼んだときに Claude Code が自動で使って、読むファイルとトークンが減るのか。どちらなのかで、入れる価値も入れ方も変わります。
答えを出すために、はてなベースがお客様に販売している自社 ERP(3,501 ファイル)のコードで、同じ調査依頼 5 つを「Graphify を入れる前」と「入れた後」で Claude Code に 3 回ずつ頼み、読んだファイル数、トークン、グラフを引いた回数、答えの正しさを比べています。あわせて、公開 OSS 2 つと ERP でグラフを作る手順と所要時間、無料で動く範囲、可視化の限界も載せています。
トークンを減らす目的で入れる意味は無かった。常に自動でグラフを参照させる設定(フック)にすると入力トークンは中央値で 46% 増え、答えの正しさは入れない場合と同じだった。効かない理由は 3 つ。グラフの返答が重い(型を 1 つ聞くと 3,400 件前後が該当する)、返るのは名前と行番号だけで結局そのファイルを読む、常設の指示とツール定義が毎回の入力に乗る。特に業務の言葉で横断する依頼(工数から請求まで、通知の経路)では 87% 増えた。効いたのは型や関数の名前を 1 つ指した影響範囲調査だけで、9 回中 7 回はファイルを開かずに正答した(トークンは同程度)。おすすめは、グラフはコミット時に自動更新しておき、その種の調査のときだけ「グラフで調べて」と明示して使う形。入れ方は 2 つあり、ユーザー単位の導入では自分で /graphify と打たない限り何も起きず、プロジェクト単位(--project)まで入れると自動で参照するようになる(実測 15 回中 15 回)
この記事の要約
この記事の検証条件
検証環境は graphify 0.9.65(2026 年 9 月 22 日時点)と macOS(Apple シリコン)です。のキーは一切設定せず、全コマンドを API キーの環境変数を外した状態で実行しました。文書・画像の意味付け(生成 AI が要る処理)は実施していません。コミュニティの命名だけは Claude Code の定額契約経由で行い、その旨を本文に明記しています。
使い方は 2 つあり、それぞれ入れ方が違う
紹介記事の多くはこの区別を書いていません。
| 使い方 | 何が起きるか | 必要な設定 |
|---|---|---|
| 自分で見る | graph.html で塊と接続を眺める。で「接続の多い型」「循環参照」を読む。 | graphify と を実行するだけ |
| 自分で Claude Code に引かせる | Claude Code の中で /graphify 「この型を使うのは誰か」と打つ | graphify install --platform claude(ユーザー単位) |
| Claude Code に自動で使わせる | 調査や実装を頼むと、Claude Code が の前にグラフへ問い合わせる。 | プロジェクトで graphify install --platform claude (実測はこの設定)。運用では MCP 登録と、後にグラフを更新するを足す。 |
多くの人が期待している「入れたら勝手に効く」は表の 3 番目の使い方で、ユーザー単位の導入では起きません。ユーザー単位で書き込まれるのは、Claude Code の設定フォルダに置くスキル本体と、「利用者が /graphify と打ったらこのスキルを使え」という短い指示だけです。プロジェクト単位まで入れると、そのの に「コードの質問はまず graphify query を実行せよ。コードを変えたら graphify update を実行せよ」という 10 行が追記され、さらに が 2 本入ります。フックは grep やファイル読み込みのたびに「先にグラフを引け」という指示を差し込みます。さらに --strict を付けた場合は、最初のファイル読み込みを、グラフへの問い合わせが 1 回行われるまで実際に止めます。
では、その状態で本当に自動で使うのか、使ったとして何が変わるのか。ERP のコードで測りました。
ERP で同じ調査依頼を 30 回頼んで、入れる前と後を比べた
トークンを減らす目的では、入れる意味がありませんでした。常に自動で参照させる設定にすると入力トークンは中央値で 46% 増え、答えの正しさは入れない場合と変わりません。Claude Code は Graphify が無くても grep で同じ答えに辿り着いていました。効かない理由は、グラフの返答が重いこと、返るのが名前と行番号だけで結局ファイルを読むこと、常設の指示が毎回の入力に乗ることの 3 つで、詳しくはトークンの節に書きます。効かない依頼は、工数から請求まで、通知の経路のように業務の言葉で横断するもの(87% 増)。効く依頼は、型や関数の名前を 1 つ指した影響範囲調査(9 回中 7 回、ファイルを開かずに正答)です。残る使い道はその影響範囲調査と、接続の偏りや循環参照を機械的に出す設計レビューに限られます。なので、グラフはコミット時に自動更新しておいて、影響範囲を調べるときだけ明示して使うのがおすすめです。自動で参照するかどうかで言えば、条件 B の 15 回すべてで Claude Code は自分からグラフを引きました。問題はその先です。
ERP のリポジトリの読み取り専用コピーを作り、条件 A(Graphify 無し)と条件 B(プロジェクト単位で導入、--strict、MCP 登録、命名済みのグラフ 26,927 ノードを配置)を用意しました。両方の条件で同じ調査依頼 5 つを Claude Code に 3 回ずつ頼みました。条件を揃えるため、ファイルの変更を禁止し、同じモデルを使い、Claude Code が別の作業者(サブエージェント)を起動することも禁止しています。実行後に Claude Code が出す使用量の記録から、入力トークン、出力トークン、所要時間、読んだファイル数、グラフへの問い合わせ回数を集計しました。合計 30 回です。なお依頼は調査と変更手順の提案までで、実際にコードを変更させる依頼は測っていません。
| 依頼 | 内容 | 型 |
|---|---|---|
| T1 | BusinessAccess 型を変更したとき影響を受ける箇所を列挙し、変更手順を提案せよ | 起点を 1 つ指す |
| T4 | ErpRepository を差し替えると影響する箇所を列挙し、差し替え手順を提案せよ | 起点を 1 つ指す |
| T5 | AuthorizedTx を使っている処理を列挙せよ | 起点を 1 つ指す |
| T2 | 通知がどこから送信されるか、送信処理までの呼び出し経路を説明せよ | 業務の言葉で横断 |
| T3 | 工数の登録から請求に関わるモジュールを洗い出せ | 業務の言葉で横断 |
入力トークンは減らず、中央値で 46% 増えた
回ごとの振れが大きいので、平均ではなく 15 回ので比べます。入力トークンは 46% 増え、料金は 19% 増えました。所要時間も 33% 延びています。出力トークンだけはほぼ同じでした。
| 指標(15 回の中央値) | A: Graphify 無し | B: Graphify あり | 差 |
|---|---|---|---|
| 入力トークン | 495,757 | 724,293 | +46% |
| 出力トークン | 4,264 | 4,260 | 0% |
| 所要時間 | 50.4 秒 | 67.1 秒 | +33% |
| グラフへの問い合わせ | 0 回 | 2 回(最大 7 回) | |
| 答えの正しさ(実コードと照合) | 15 回とも正 | 15 回とも正 |
表の入力トークンは、過去のやり取りを再利用するからの読み込みを含む値です。答えの正しさは両条件とも 30 回すべて実コードと一致していたので、減らなかったのは精度と引き換えではありません。増えた理由は 3 つほど確認できました。1 つ目は、グラフの問い合わせ結果そのものが重いことです。BusinessAccess を聞くと 3,400 件前後(回によっては 5,800 件)のノードが該当し、2,000 トークンの予算では 50 件前後しか表示されないと警告が出るほどで、切り詰めても相応の量が入ります。2 つ目は、グラフが返すのが名と行番号なので、変更手順を書くには結局その行を読むことです。3 つ目は、CLAUDE.md の 10 行と MCP ツール 10 本の定義が毎ターンの入力に乗り、スキルを読んだ回はさらに本体 41 KB が乗ることです。
測定の振れ幅
同じ依頼を同じ条件で 3 回頼んでも、入力トークンは最大で 3.7 倍(T4 の条件 A で 414,768 から 1,545,119)振れました。このため、中央値どうしで 15% 程度の差は意味のある差として扱えません。上の表で意味があるのは、振れ幅が重ならない全体の +46% と、次に示す依頼の型ごとの差です。
効いたのは、型や関数の名前を 1 つ指した依頼だけだった
依頼を「起点を 1 つ指す」3 つと「業務の言葉で横断する」2 つに分けると、トークンの増減の向きが逆になります。
| 依頼の型(中央値) | 入力トークン A → B | 料金 A → B | 読んだファイル A → B |
|---|---|---|---|
| 起点を 1 つ指す(T1・T4・T5) | 426,515 → 480,712(+13%) | $0.253 → $0.255(+1%) | 2 → 0 |
| 業務の言葉で横断(T2・T3) | 529,861 → 988,391(+87%) | $0.295 → $0.442(+50%) | 1 → 3 |
起点を指す依頼では、9 回中 7 回で Claude Code はファイルを 1 本も開かずに正答しました(条件 A は 9 回中 1 回)。AuthorizedTx を聞いた T5 は 3 回とも、読んだファイルが 0 本でした。トークンは同程度ですが、ファイルを読まずに答えが出るので、1 ファイルが大きいリポジトリほど読み込みを省いた分のトークン削減が大きくなる余地があります。
業務の言葉で横断する依頼では、6 回すべてで条件 B の方が重くなりました。グラフの語彙は関数名とファイル名で、質問の語彙は工数・請求・通知です。この 2 つが合わないため Claude Code は問い合わせを重ね(T3 は中央値 6 回)、それでも足りずに読むファイルが 3 倍に増えています。この差は、文書やコメントを生成 AI で意味付けしてグラフに入れないと埋まりませんが、今回の検証ではその処理を実施していません。
Graphify に「トークンを減らす道具」を期待すると外れます。実測どおりに効くのは、起点が分かっている調査で、ファイルを開かせずに当たりを付けさせる使い方です。
Graphify は何を作るのか
Graphify は、フォルダの中身をナレッジグラフに変換するコマンドラインツールです。GitHub の説明文には「コード、文書、、設定、PDF を問い合わせ可能なナレッジグラフに変える」とあります。社内コードに向ける前に確認したのは出どころとライセンスで、開発元は Graphify Labs(の 2026 年夏期出身)、ライセンスは でした(リポジトリには MIT の許諾文も併置されています)。業務コードを解析させても、解析結果の扱いに制約は付きません。
ナレッジグラフと言うと大げさに聞こえますが、中身は「点と線」です。点(ノード)は関数・クラス・ファイル・テーブル、線(エッジ)は「呼んでいる」「取り込んでいる」「継承している」といった関係で、すべての線に、その関係を見つけたファイル名と行番号が記録されます。実行すると出力フォルダに次のファイルが書き出されます。
| 生成物 | 中身 | 誰が使うか |
|---|---|---|
| graph.json | ノードとエッジの全データ。何度でも問い合わせできる。 | Claude Code などのエージェント(MCP 経由)と CLI |
| graph.html | ブラウザで開く対話型の地図。色分け・検索・クリックで詳細。 | 人 |
| GRAPH_REPORT.md | 要約。最も接続の多いノード、循環参照、推奨する質問の一覧。 | 人とエージェントの両方 |
処理は 2 種類に分かれています。コードの解析は という器が担い、生成 AI を使いません。同じコードからは同じグラフができ、ネットワークにもつながりません。一方、文書・画像・PDF の意味付けと、グラフの塊(コミュニティ)への命名は、今回の 0.9.65 では生成 AI を使う処理です。「無料で動く」と言われているのは前者だけで、後者にはモデルの契約が別に必要になります。
用語メモ|コミュニティ
グラフの中で互いに結びつきが強いノードの塊。Graphify は という手法で自動検出し、画面上では同じ色で表示します。命名を行うと「Session Object」「HTTP Adapter」のような名前が付き、目次として使えるようになります。命名しないと「Community 0」「Community 1」のままです。
導入手順と実際に打ったコマンド
前提は Python 3.10 以上と、か のどちらかです。上のパッケージ名は y が 2 つの graphifyy で、コマンド名は graphify です。README によれば本来の名前を取り戻す交渉中の暫定措置とのことです。ここを間違えると別のパッケージが入るので、コピーして使ってください。
# 本体。SQL と MCP サーバーの依存を最初から入れておく(理由は後述)
uv tool install "graphifyy[sql,mcp]"

# 入ったことを確認
graphify --version
# → graphify 0.9.65
角括弧の中は追加機能の指定です。素の graphifyy だけを入れると、SQL ファイルの解析と の起動ができません。どちらも実行時の警告かエラーで分かりますが、最初から入れておく方が手戻りがありません。
Claude Code に組み込む
graphify install --platform claudeこのコマンドは Claude Code の設定フォルダに、本体(skills/graphify/SKILL.md)と、スキルが参照する説明書 8 本を置き、ユーザー用の CLAUDE.md に「/graphify と打たれたらこのスキルを使え」という 3 行を追記します。これで Claude Code の中から /graphify と打てるようになりますが、打たない限り何も起きません。対応先は Claude Code のほか Codex、Cursor、Gemini CLI、Kiro など 20 以上で、platform の指定を変えるだけです。
自動で使わせる設定(プロジェクト単位)
# 実測で使った 1 行。リポジトリの直下で実行すると CLAUDE.md への追記とフック 2 本、スキルの同梱が入る
cd /path/to/repo
graphify install --platform claude --project --strict

# 運用で足す 2 行(今回の実測では未使用)
# コミット後にグラフを更新する git フックを入れる
graphify hook install
# Claude Code がツールとして直接グラフを引けるようにする
claude mcp add graphify -- graphify-mcp /path/to/repo/graphify-out/graph.json
実測で「自動でグラフを使った」のは 1 行目の設定です。MCP は実測では一時的な設定ファイルで渡し、は使っていません。1 行目で書き込まれるのは、リポジトリの CLAUDE.md への 10 行(コードの質問はまず graphify query、コード変更後は graphify update)、.claude/settings.json のフック 2 本(grep と検索の前、ファイル読み込みの前)、.claude/skills/ へのスキル同梱です。--strict はセッション最初のファイル読み込みを、グラフへの問い合わせを 1 回するまで止める保険で、一度問い合わせれば 30 分は解除されます。グラフが対象ファイルより古いときは止めず、注意だけ出します。
install は設定フォルダを書き換える
スキルの追加と CLAUDE.md への追記は、そのまま全プロジェクトに効きます。試すだけなら、環境変数 CLAUDE_CONFIG_DIR で使い捨ての設定フォルダを指定してから実行すると本番の設定を汚しません(ただしその設定フォルダで claude 本体を動かすと、定額契約の認証が付いてこない場合があります)。元に戻すには graphify uninstall を使います。
グラフを作る
Claude Code の中なら /graphify . の一行で済みますが、ターミナルから直接動かす場合は 2 段のコマンドになります。README や公式ブログには /graphify . しか書かれていないため、CLI で graphify . と打つと「そんなサブコマンドは無い」と言われます。
# 1. 構文解析してグラフを作る(生成 AI 不使用、課金なし)
#    --code-only: 文書・画像を飛ばす。これを付けないと API キーが無い環境では止まる
#    --out: 出力先をリポジトリの外に出す(省略するとリポジトリ内に graphify-out/ ができる)
graphify extract /path/to/repo --code-only --out /path/to/work

# 2. コミュニティ検出とレポート・HTML の生成
#    --no-label: コミュニティの命名(生成 AI を使う)を止める
graphify cluster-only /path/to/work --no-label

# 3. ブラウザで地図を開く
open /path/to/work/graphify-out/graph.html
問い合わせる
# 自然文で聞く(生成 AI ではなく、固有名詞の照合と幅優先探索)
graphify query "What calls CaseInsensitiveDict?" --graph /path/to/work/graphify-out/graph.json

# 2 つのノードの最短経路
graphify path "Session" "HTTPAdapter" --graph .../graph.json

# 1 つのノードとその周辺を説明させる
graphify explain "BusinessAccess" --graph .../graph.json

# 最も接続の多いノード(設計の中心)を列挙
graphify god-nodes --top 10 --graph .../graph.json

# コードを変えた後の差分更新(生成 AI 不使用)
graphify update /path/to/repo
Claude Code から直接グラフを引かせたい場合は サーバーとして登録します。graphify-mcp というコマンドが graph.json を引数に取って起動し、10 個のツールを公開します。問い合わせの query_graph、ノード取得の get_node、隣接の get_neighbors、塊の取得 get_community、接続が集中する中心ノードを出す god_nodes、統計の graph_stats、最短経路の shortest_path の 7 つと、GitHub の PR 連携が 3 つです。登録は Claude Code の通常の手順()で行います。MCP の仕組みは別記事にまとめています。
公開 OSS で動かす(requests と FastAPI)
社内コードに当てる前に、結果を誰でも検証できる公開 OSS で挙動を確かめました。規模の違うものを 2 つ選びました。Python の HTTP ライブラリ requests(38 ファイル)は、図の読み方を覚えるのに手頃な小ささで、Web フレームワーク FastAPI(コード 1,148 ファイル。別に文書 1,739 件と画像 243 件があるが今回は除外)は、大きくなったときに何が起きるかを見るためです。どちらも した直後の状態で、コードだけを対象にしました。
| psf/requests | fastapi/fastapi | |
|---|---|---|
| コードファイル数 | 38 | 1,148(約 11 万行) |
| 構文解析の所要時間 | 4.016 秒 | 6.928 秒 |
| ノード / エッジ / コミュニティ | 1,265 / 2,444 / 109 | 8,825 / 18,186 / 758 |
| 構文から確定した線の割合 | 93%(推測 7%、平均確信度 0.92) | 98%(推測 2%、平均確信度 0.89) |
| 命名まで含めた後処理 | 25.4 秒 | 2 分 18 秒 |
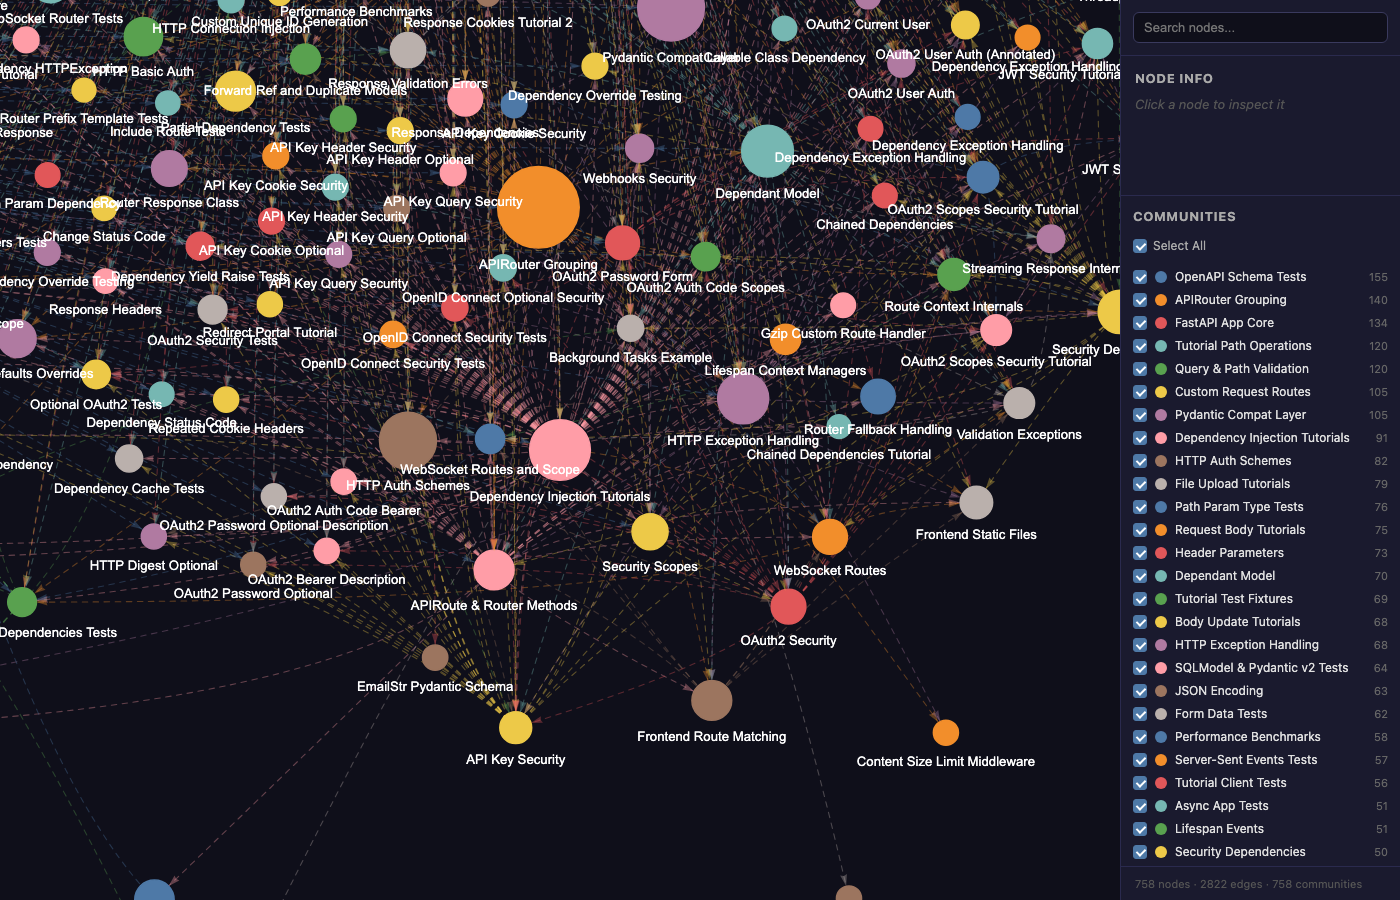
表の 2 行目を見ると、構文解析そのものは速く、11 万行が 7 秒で終わっています。時間が掛かったのは最後の行の「命名」で、ここだけ生成 AI を呼ぶためです。FastAPI では 758 個のコミュニティに名前を付けるのに 2 分以上待ちました。まずは出来上がった graph.html をブラウザで開きます。
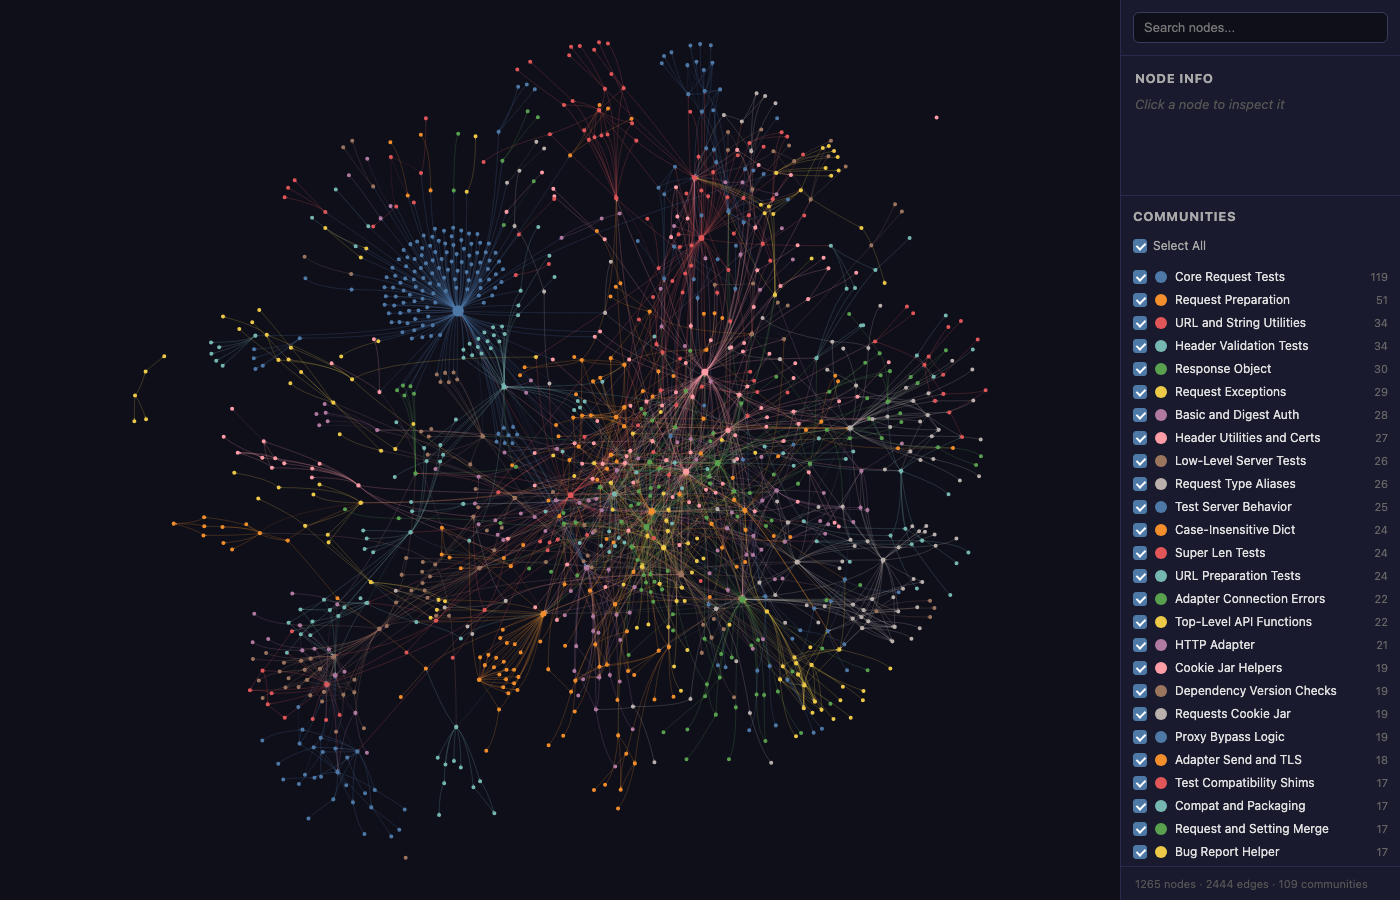
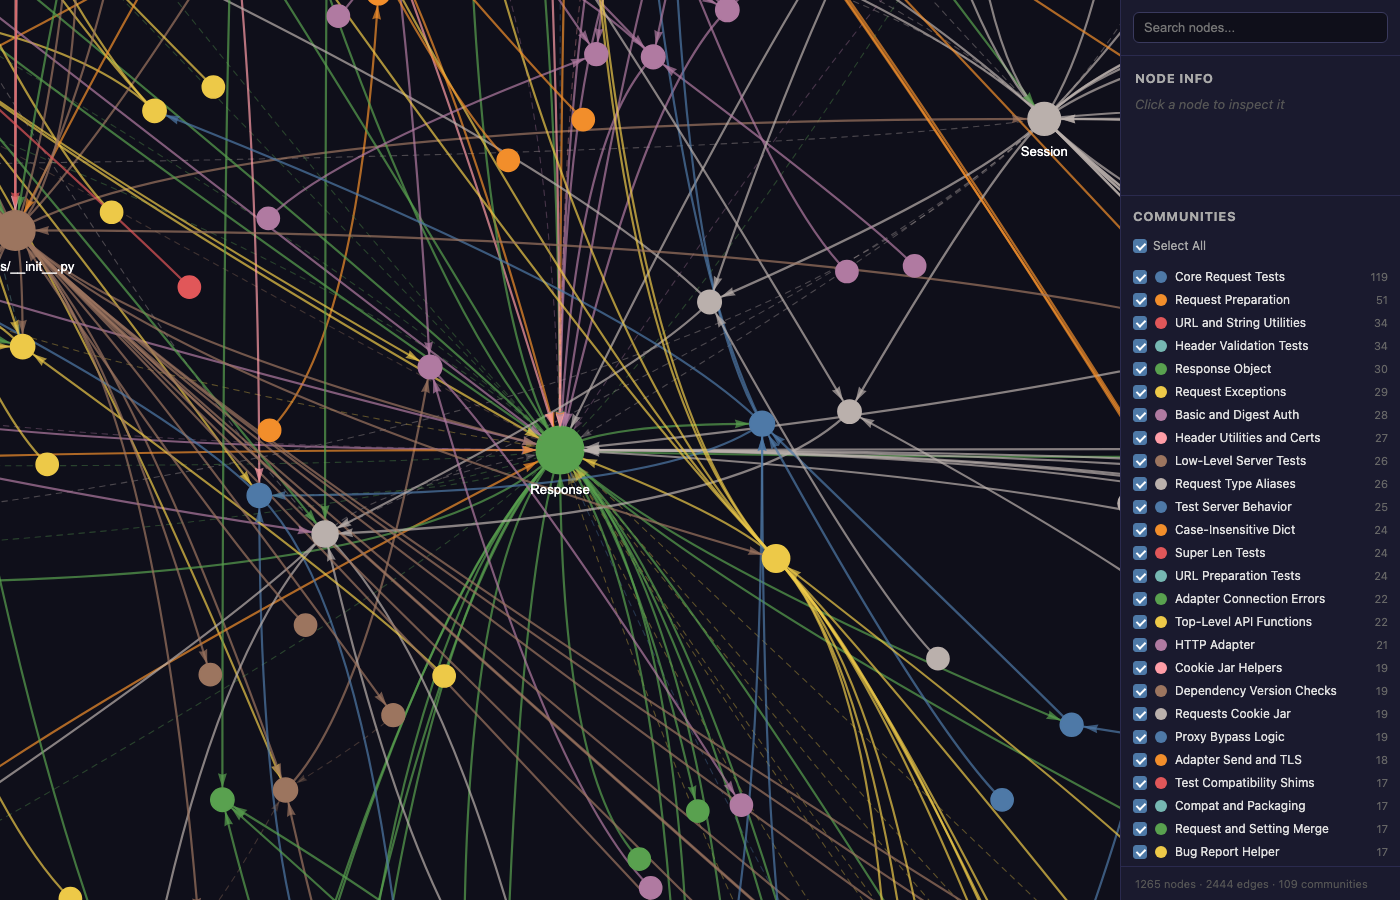
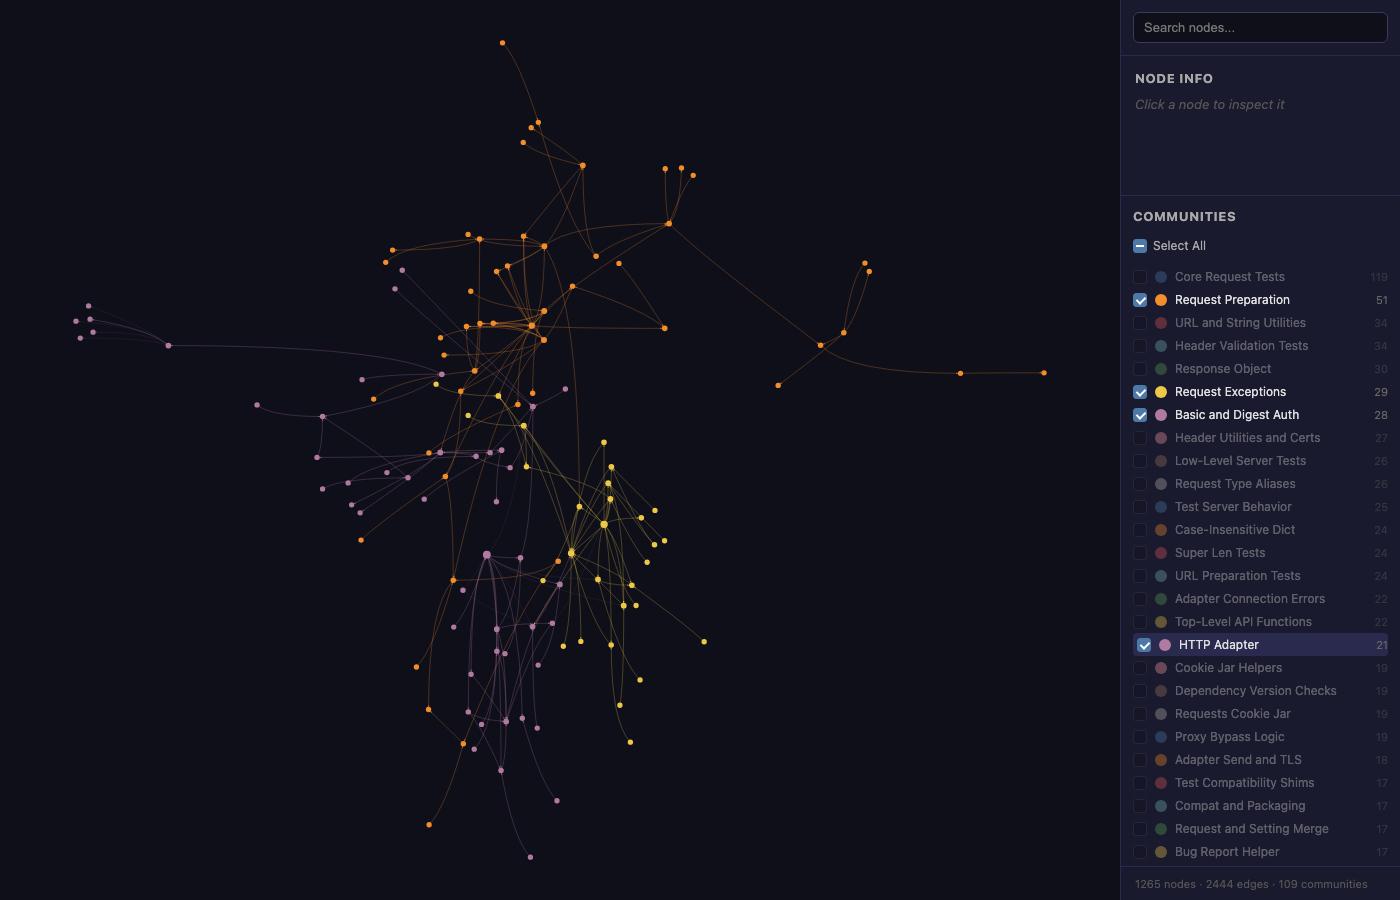
全体図では大半のノードに文字が付きません。1,265 ノード中、ラベルが描かれるのは接続数の多い 18 個だけです。これは仕様で、名前を読むには画面を拡大するか、ノードをクリックします。
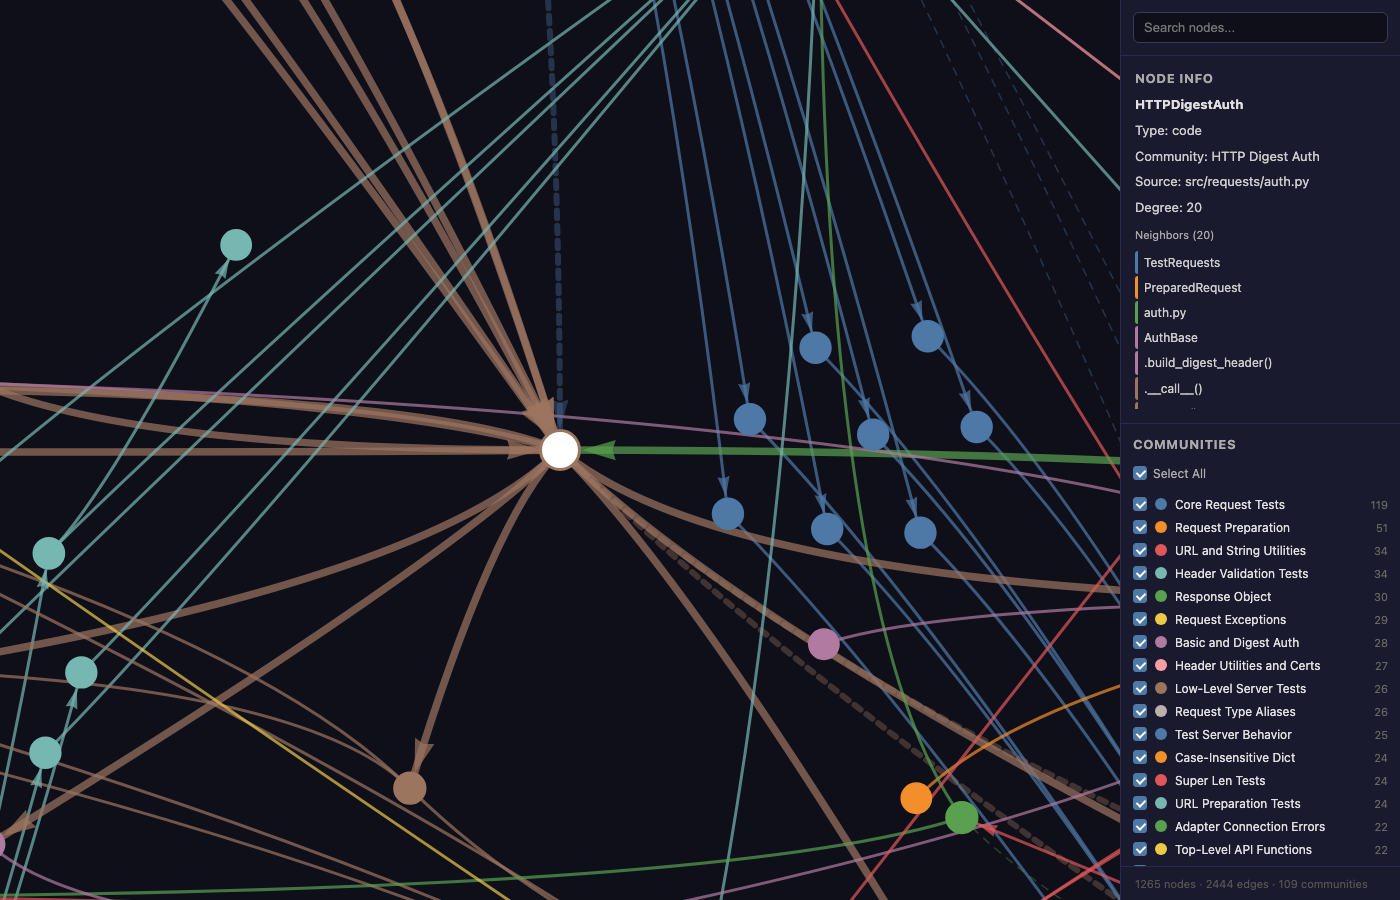
レポートには副産物として設計上の指摘も出ます。requests では 3 ファイルで一周するが 10 件、4 ファイルのものが 12 件列挙されました。テスト用の秘密鍵と証明書 8 件は「機密の可能性がある」として自動でグラフから外され、その旨が標準出力に残ります。
お客様に販売している自社 ERP(3,501 ファイル)で動かす
続いて、はてなベースが自社開発してお客様に販売している基幹業務システム(ERP)のリポジトリで動かしました。Go のバックエンド、TypeScript のフロントエンド、Python のスクリプト、1,185 本の SQL ファイルからなる構成で、git 管理下のファイルは 5,043 件です。そのうち Graphify がコードとして扱ったのは 3,501 ファイルでした。requests の 100 倍近い規模なので、時間かメモリのどちらかで止まるだろうと見ていました。出力先は でリポジトリの外に逃がし、実行前後で が変わらないことを確認したうえで実行しています。
| 項目 | 値 |
|---|---|
| 構文解析の所要時間 | 23.65 秒(18 並列) |
| ノード / エッジ / コミュニティ | 26,927 / 72,550 / 1,826 |
| 構文から確定した線 | 93%(推測 7%、5,376 本、平均確信度 0.85) |
| 生成 AI のトークン消費 | 入力 0・出力 0(レポートの Token cost 欄) |
| 循環 import | 0 件 |
| 生成物のサイズ | graph.json 39.5 MB、graph.html 1.4 MB、レポート 3,659 行 |
予想は外れ、メモリ不足も途中終了もなく 24 秒で終わりました。ただし最初の実行ではノードが 24,155 にとどまり、標準出力の末尾に警告が 1 行出ていました。
warning: 1185 .sql file(s) contributed nothing to the graph because a dependency is missing:
tree_sitter_sql not installed. Install it with: pip install "graphifyy[sql]" (#1745)
素の graphifyy には SQL の構文解析器が入っておらず、1,185 本の SQL が丸ごと無視されていました。この ERP はデータベース側に業務ロジック(関数・ビュー・トリガ)を置いているので、既定のままではグラフの半分が欠けます。graphifyy[sql] を入れて再実行するとノードが 2,772 増え(うち SQL 由来 2,237)、コミュニティは 721 から 1,826 になりました。導入手順で最初から [sql] を付けたのはこのためです。
レポートから読み取れた設計の事実
生成 AI を使わずに得られた所見のうち、実際に役に立ったのは「最も接続の多いノード」の一覧です。
$ graphify god-nodes --top 5
  1. BusinessAccess - 1371 edges
  2. ErpRepository - 409 edges
  3. vitest - 358 edges
  4. authorization() - 357 edges
  5. AuthorizedTx - 352 edges
1 位の BusinessAccess は「事業所ごとのアクセス権」を表す型で、レコードの作成・更新・一括更新・税務関連の保存・権限判定のすべてがこの型を参照していることが解析結果で示されました。設計者の頭の中にはあった事実ですが、1,371 本という数字で裏が取れたのは初めてでした。コマンドに BusinessAccess を渡せば主な接続先が定義ファイルと行番号付きで並ぶので、この型を変える前の影響調査がそのまま済みます。
全体図は「点の集まり」になる
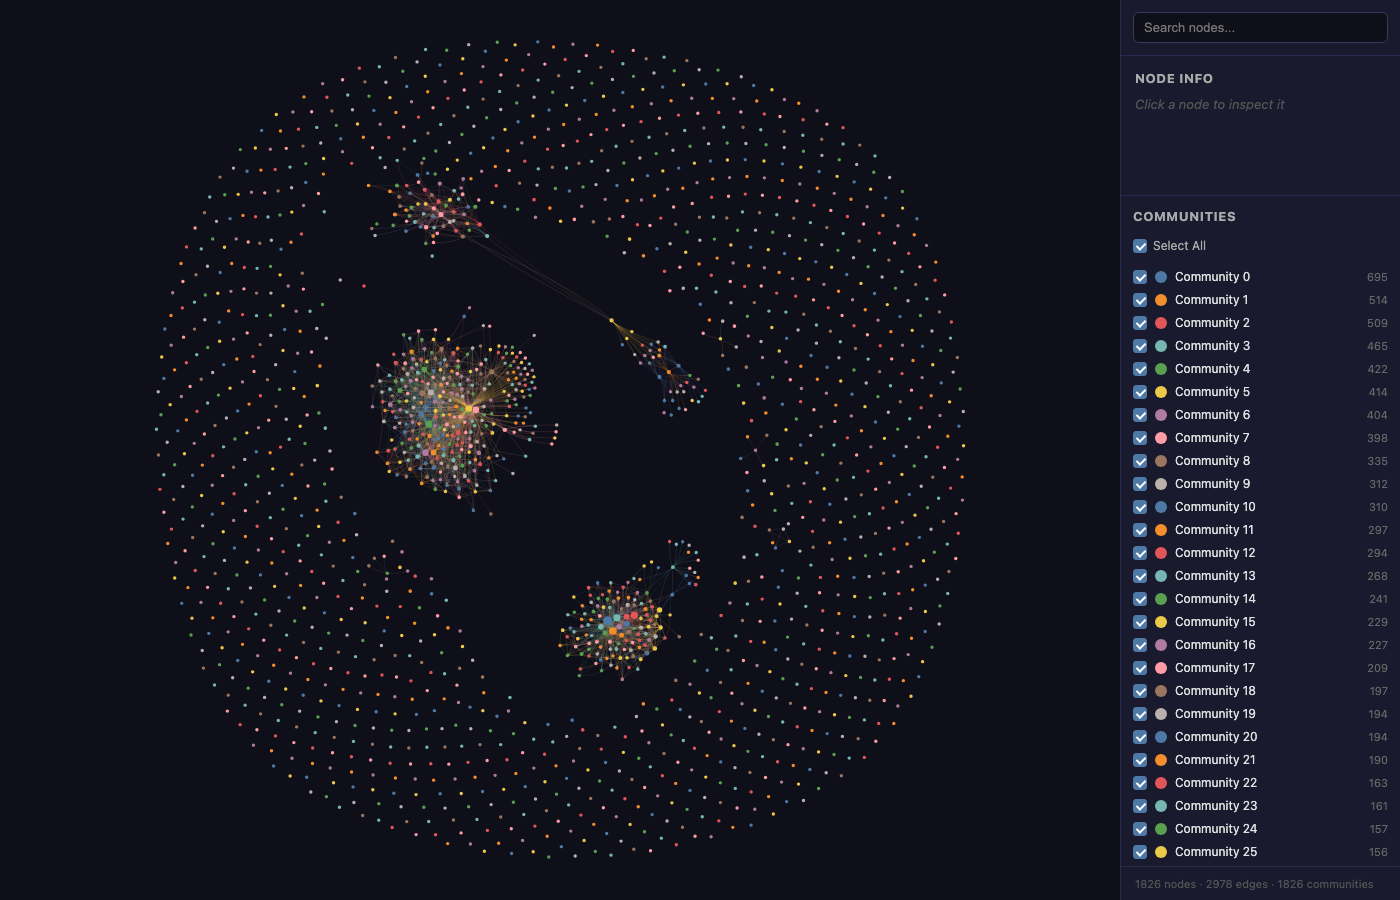
ノードが 5,000 を超えると、graph.html は描画負荷を抑えるため、コミュニティを 1 点に畳んだに自動で切り替わります。ERP では 1,826 個の色付きの点になり、拡大しても文字は出ません。命名をしていないため右の一覧も「Community 0」から番号が並ぶだけで、目次として機能しません。
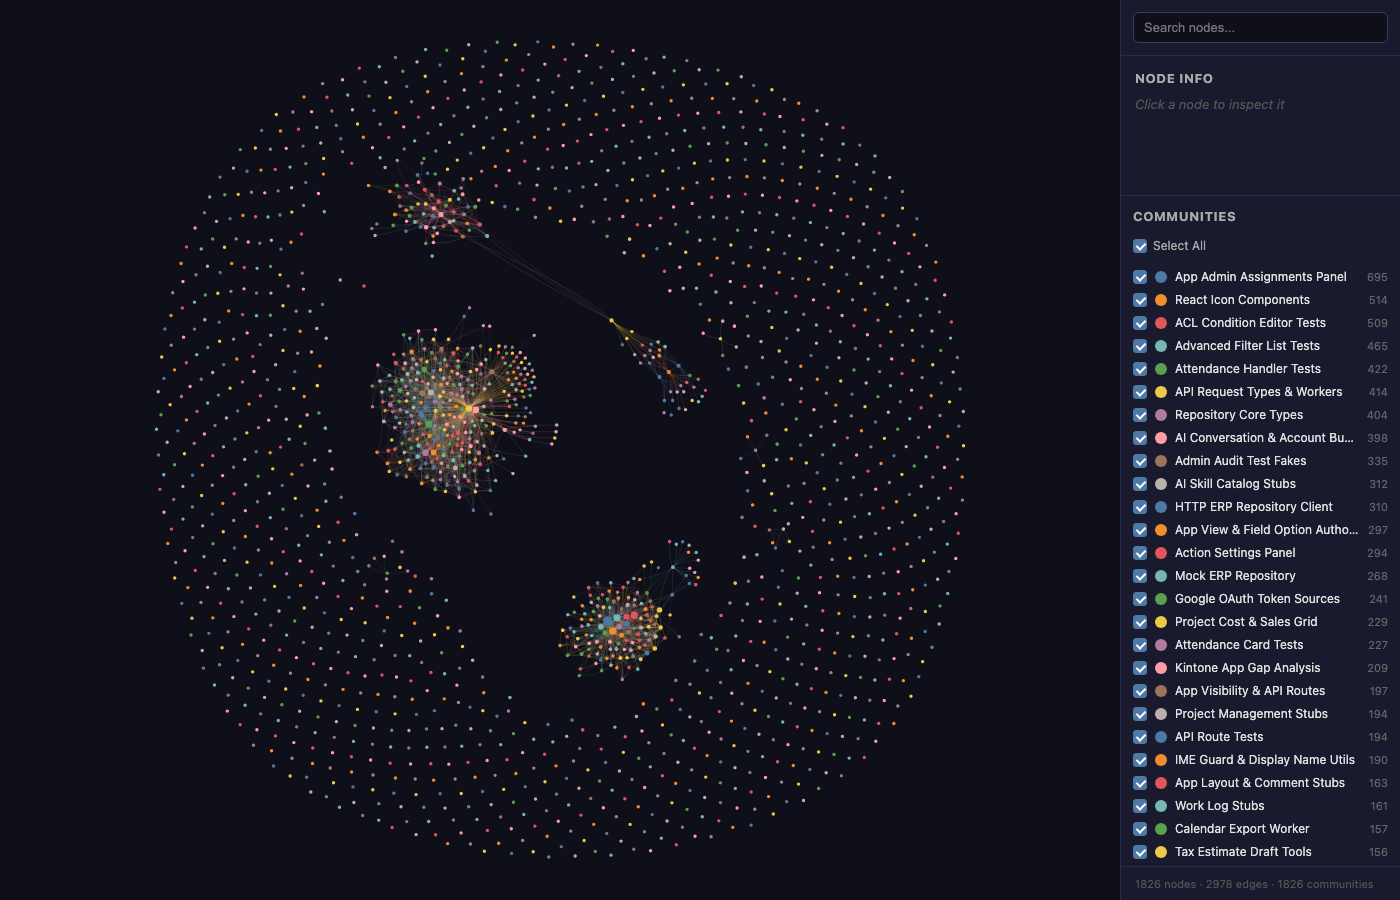
次の図は、命名まで行った全体図です。1,826 個すべてに名前が付き、右の一覧は App Admin Assignments Panel(アプリ管理者の割り当て画面)、ACL Condition Editor Tests、Google OAuth Token Sources のような目次になりました。この命名は Claude Code の定額契約経由で 355 秒掛かり、入力トークンは 966,655 でした。ただし 26,927 ノードの集約図では、名前が付いても画面上の点には文字が描かれず、一覧と検索から辿るしかありません(FastAPI の 758 コミュニティでは集約図の点にも名前が描かれました)。
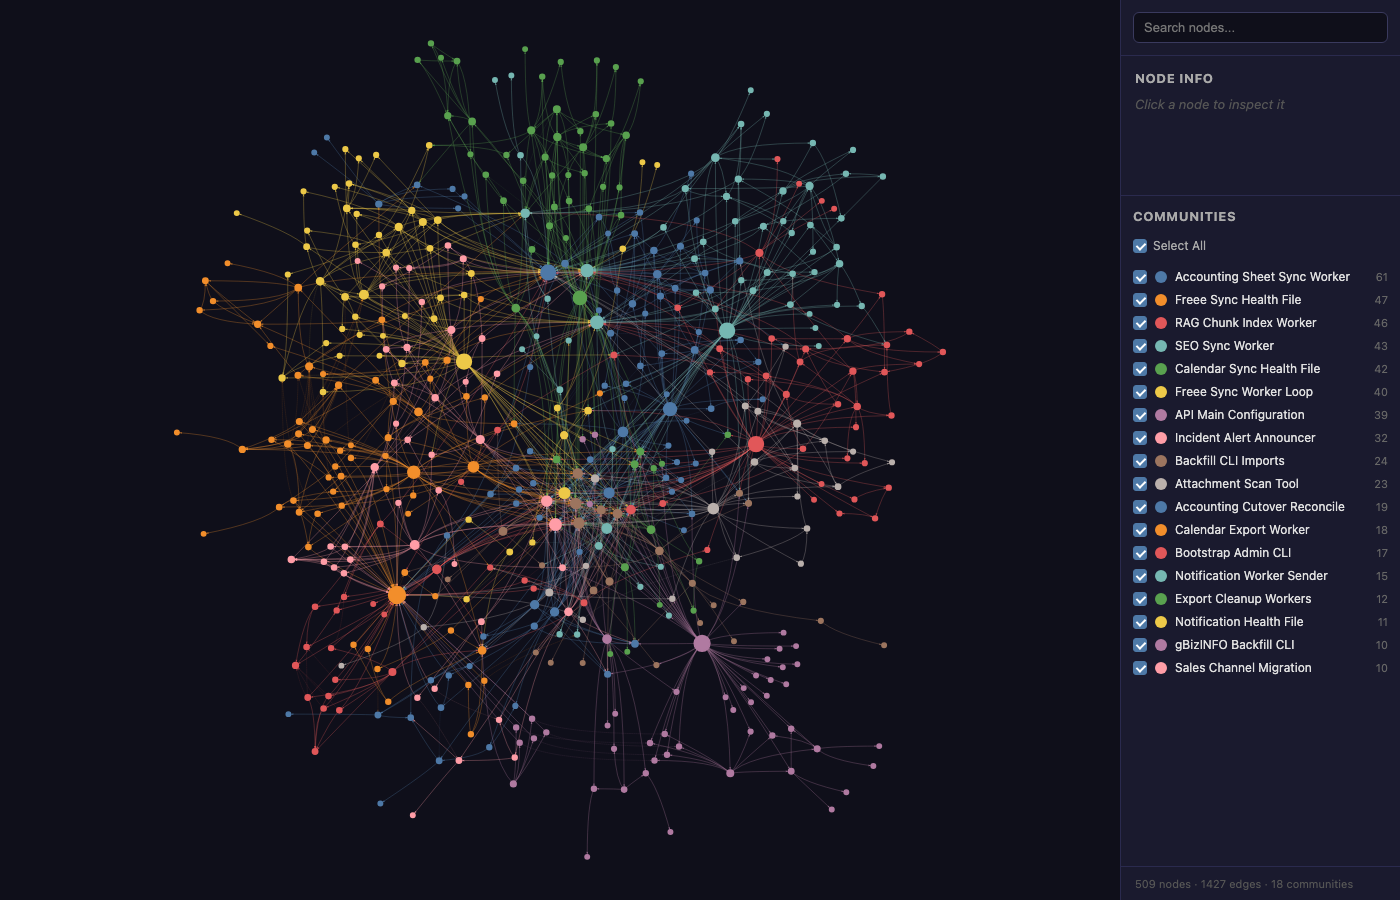
個々の関数まで描いた図を見たい場合は、5,000 ノード未満になるようにディレクトリを絞ります。バックエンドのバッチ処理だけ(509 ノード)を対象にし、命名まで行ったのが次の図です。
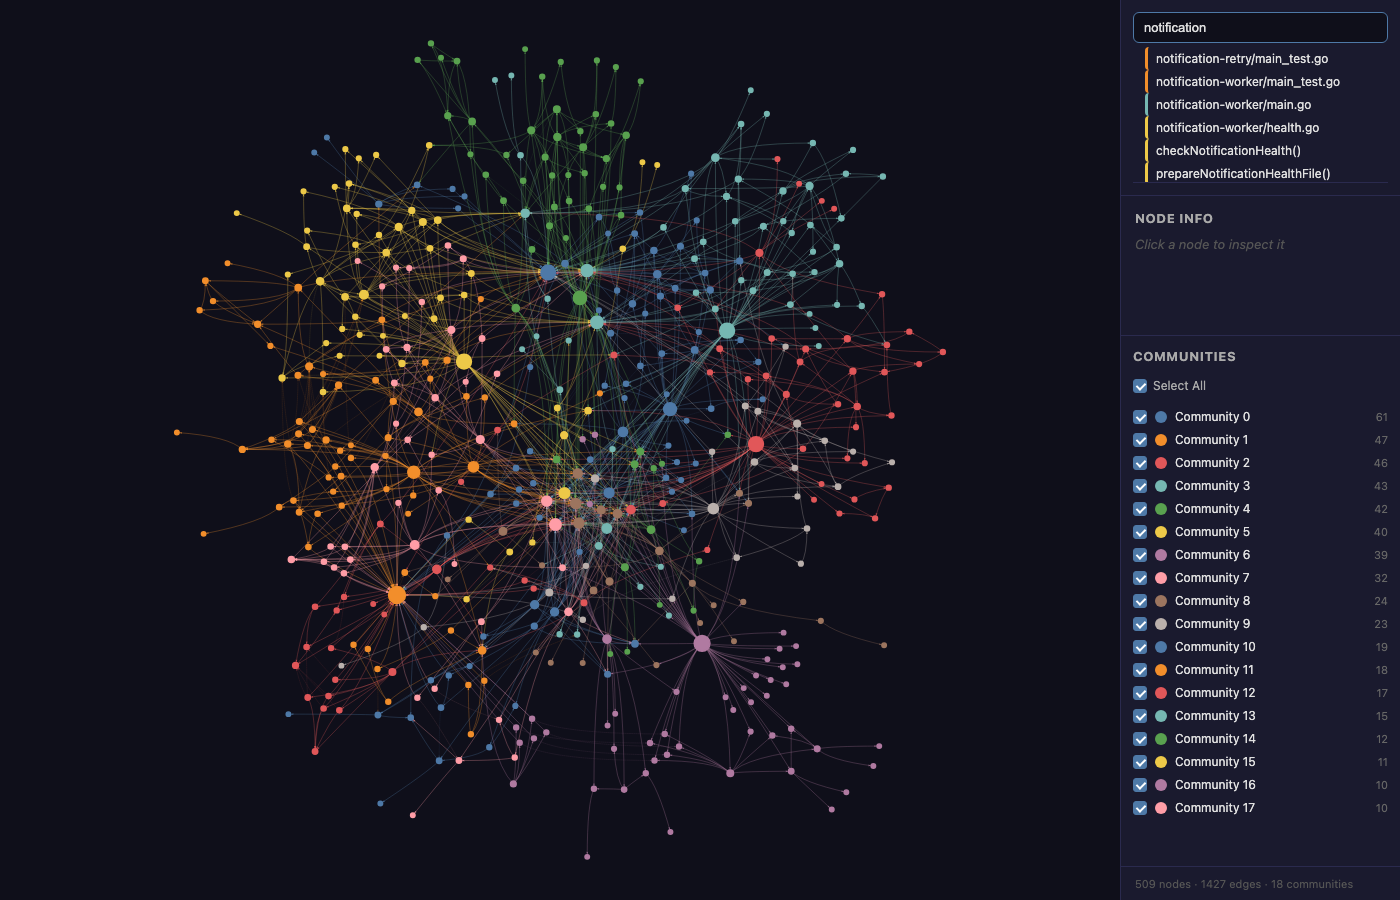
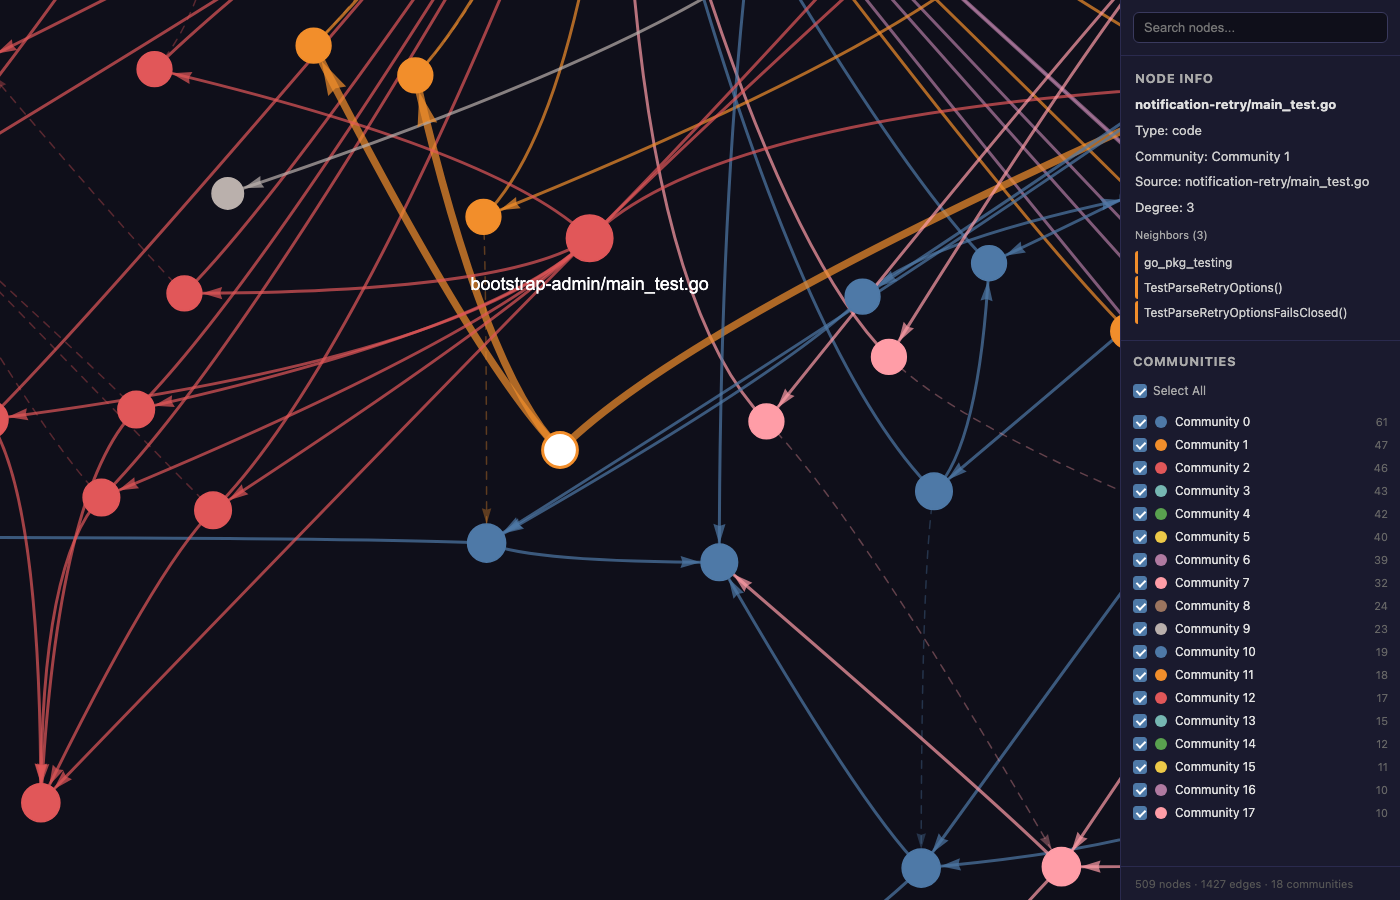
自然文の質問は外れ、名前を指した質問は当たる
グラフができたら、次に知りたいのは質問に答えられるかです。query コマンドは生成 AI を使わず、質問文から固有名詞を拾って起点ノードを決め、そこから 2 分をたどって返すだけの処理です。応答は 0.1〜0.9 秒で、費用も掛かりません。その代わり、質問の書き方で結果が大きく変わります。
| 質問 | 対象 | 結果 | 評価 |
|---|---|---|---|
| Session クラスはどこから呼ばれるか | requests | 2 ノード。無関係なテスト関数を起点に拾った。 | 外れ |
| What calls CaseInsensitiveDict? | requests | 37 ノード。呼び出し元 24 箇所を行番号付きで列挙(本体 6 箇所、残りはテスト) | 正解 |
| HTTPAdapter はどうコネクションプールを作るか | requests | 211 ノードに広がり、既定の 2,000 トークン予算で 149 件が切り捨て | 部分的に正解 |
| 承認フローに関わる関数はどれか | ERP | 64 ノード。組織階層の DB 関数は拾えたが、申請・承認の本体に届かない。 | 部分的 |
| 工数登録から請求までの経路 | ERP | registration という英単語がテスト関数名に一致し、起点が全部テストコード | 外れ |
| 通知はどこから送られるか | ERP | 2 ノード。実際にある通知処理に辿り着かない。 | 外れ |
6 問投げて当たったのは 1 問、部分的に当たったのが 2 問です。クラス名や関数名を 1 つ指定した質問は行番号付きで正確に返り、業務用語(承認、工数、請求)で聞くと外れます。業務用語で引きたいなら、文書やコメントの意味付け(生成 AI が要る処理)を先にやっておく必要があります。今回はそこを実施していないので、この弱さは「コードだけのグラフ」の限界として読んでください。
なお MCP サーバー経由でも同じ結果が返ります。グラフを引く 7 つのツールはいずれも応答 10 ミリ秒未満でした(GitHub の PR 連携 3 つは未検証)。事前に作った graph.json を読むだけで、問い合わせ時点では生成 AI もネットワークも使わないためです。
何が無料で、何にモデルが要るか
費用は「グラフを作る・更新するとき」と「Claude Code がグラフを引くとき」で別に考えます。作る側は構文解析だけなので、コミットごとに自動更新しても 1 日 1 回回しても課金はゼロで、塊への命名だけが生成 AI を使います。一方、引く側は依頼のたびにその回の入力に乗るので、グラフを何回更新しても 1 回の問い合わせの費用は下がりません。「一度作れば使うほど安くなる」という関係にはなっていない点に注意してください。
| 処理 | 生成 AI | 今回の実測 |
|---|---|---|
| コードの構文解析(extract) | 使わない | 3,501 ファイルで 23.65 秒、課金 0 |
| コミュニティ検出(cluster-only) | 使わない | 5.91 秒 |
| 問い合わせ(query / path / explain / MCP) | 使わない | 0.1〜0.9 秒 |
| コミュニティの命名(label) | 使う | 509 ノードの部分グラフで 8 秒、ERP 全体 1,826 個で 355 秒(Claude Code の契約枠) |
| 文書・画像・PDF の意味付け | 使う | 未実施(API キー無しでは extract が停止する) |
ここまでの検証で、従量課金の API は一度も呼んでいません。ただし上の表の最後の行、文書・画像の意味付けは未実施のままです。公式ブログの「API キー不要、既定でローカル動作」はコードだけのリポジトリに限った話で、README や画像が 1 つでも混ざると、を付けない限り解析前に止まります。止まったときのエラー文に対処法が書いてあるので、迷うことはありません。
なお、コミュニティの命名は API キーを設定していなくても、Claude Code が入っているマシンならその定額契約の枠で動きます(--backend=claude-cli で明示できます)。今回の ERP は部分グラフ(18 コミュニティ)で 8 秒、全体(1,826 コミュニティ)で 355 秒でした。
71.5 倍は、今回の条件ではまだ届いていない
「問い合わせあたりのトークンを 71.5 倍削減」という数字は、公式ブログと、以前の README に載っていたものです。今 GitHub を開いて最初に表示される README からは消えていて、公式ブログも「利用者からの報告値で、公式の測定ではない」と断っています。それでも日本語の紹介記事の多くがこの数字を引き続けているので、Graphify に同梱されているベンチマークコマンドで実際に測りました。
| 対象 | ファイル全読み(推定) | グラフ経由 | 削減倍率 |
|---|---|---|---|
| requests | 約 84,333 トークン | 約 14,777 トークン | 5.7 倍 |
| FastAPI | 約 588,333 トークン | 約 201,425 トークン | 2.9 倍 |
requests で 5.7 倍、FastAPI で 2.9 倍。今回の条件では見出しの数字と 1 桁以上開き、コードベースが大きいほど倍率が下がりました。ただし、これで宣伝が誇張だと結論づけるのは早い。測定条件が違うからです。以前の README によると、71.5 倍は「Karpathy 氏のリポジトリ群と論文 5 本、画像 4 枚、計 52 ファイル」という、コードと文書が混ざった題材での値で、文書・論文・画像を生成 AI で意味付けしたグラフに対する数字でした。今回はコードだけを構文解析した状態で測っており、文書の意味付けは実施していません。なお同じ README は、別の題材では 5.4 倍・約 1 倍という控えめな値も併記していました。次の検証では、文書と画像の意味付けを Claude Code の契約枠で通し、質問の粒度をベンチマークの条件に揃えたうえで倍率を測り直します。
詰まりどころ
| 現象 | 原因 | 対処 |
|---|---|---|
| graphify . が「サブコマンドが無い」と言われる | /graphify . は Claude Code 内のスキル記法。CLI には無い。 | graphify extract、graphify cluster-only の順に 2 段で実行 |
| SQL が 1 本もグラフに入らない | SQL の構文解析器が既定では入らない。警告だけ出て続行する。 | graphifyy[sql] を入れて再実行 |
| graphify-mcp が ModuleNotFoundError で落ちる | 依存の mcp パッケージが既定では入らない | graphifyy[mcp] を入れる |
| 文書が混ざっていると extract が止まる | 文書・画像の意味付けには API キーかバックエンド指定が要る | --code-only を付けるか、--backend を指定 |
| 全体図がただの点の集まりになる | 5,000 ノード超で集約図に自動切替。ズームしても文字は出ない。 | ディレクトリを絞って 5,000 未満にする。または CLI の explain で読む。 |
| graph.html を開いても真っ黒 | 描画ライブラリを (unpkg)から読む。オフラインや社内網では無言で失敗。 | インターネットに出られる環境で開く。エラーは表示されない。 |
| コミュニティが Community 0、1、2 のまま | --no-label を付けたか、バックエンドが無い | --backend=claude-cli で命名。Claude Code の契約枠で動く。 |
| --strict を付けて MCP から引いたのに、ファイル読み込みが 1 回止まる | 「もう問い合わせた」の記録を更新するのが CLI だけで、MCP サーバーは更新しない(0.9.65) | 1 セッションに 1 回の読み直しで済む。避けるなら最初に CLI の graphify query を 1 回打たせる。 |
| 最も接続の多いノードがテストクラス | テストコードを含めて数えている。requests では TestRequests が 201 本で本体の Response の 2.5 倍。 | テストを除外するか、結果を読むときに割り引く |
どこで使うか
実測と 3 つのリポジトリでの検証から、向き不向きを分けると次のようになります。
- 向いている: 「この型を使っているのは誰か」「この関数を消したら何が壊れるか」のように起点を 1 つ指せる依頼です。実測では 9 回中 7 回、Claude Code がファイルを開かずに正答しました。ERP の BusinessAccess のように影響範囲が広い型の変更前に効きます。
- 向いていない: トークン削減そのものを目的に入れることです。グラフの出力と常設の指示が乗り、入力は中央値で 46% 増えました。
- 向いている: 循環 import と接続の偏りを機械的に洗い出す用途です。設計レビューの入口の資料になります。
- 向いていない: 業務用語で探す用途です。文書の意味付けをしない限り、承認・工数・請求といった言葉では当たりません。
- 向いていない: 大規模リポジトリの全体像を 1 枚の絵で見る用途です。5,000 ノードで集約図に切り替わり、個々の関数は描かれません。
- 注意: 自動でグラフを使わせるにはプロジェクト単位の導入(--project)が要ります。ただし常時使わせると入力トークンが増えるので、影響範囲調査のときだけ明示して使う運用も選べます。コードを変えたら update か hook install でグラフを追従させます。コンテキストの管理の一手段として位置づけるのがよいでしょう。
はてなベースの ERP では、実測の結果を受けて、フックも MCP の登録もグラフの自動更新もすべて外しました。Claude Code の日常の作業でトークンが増えるだけだからです。権限まわりの型を触る前に影響範囲を一覧したいときは、その場でグラフを作り直して(24 秒、課金ゼロ)explain と god-nodes を読む使い方に限っています。AI ネイティブ開発の記事で書いた「人が決めて判定する」側の仕事のひとつです。命名した 1,826 個のコミュニティ(結びつきの強いノードの塊)は細かすぎます。1 つあたりのノード数は中央値で 2 個、単独ノードだけの塊が 900 個あり、目次として使えるのは上位数十個に限られるので、ここは無理に使いません。続報として測るのは、文書 173 件と画像 1,071 件の意味付けを加えたときに、業務用語での検索とトークン削減率がどこまで伸びるかです。
コーディングエージェントの導入と運用設計を支援します
「大きなリポジトリで Claude Code のトークン消費が膨らみ、回答の精度が落ちる」「社内システムの影響範囲調査に時間が掛かる」といった状態に対し、グラフ化・MCP 連携・承認と記録の設計まで、実際に動かした結果をもとに整理します。