ECサイトで購入ボタンや「あと◯円で送料無料」の表示を変え、3日ほど購入率を見て、良さそうなら導入する。広告効果検証シリーズに続く、ECサイトのA/Bテストの例です。
購入率3%のECサイトを想定し、架空の設定によるシミュレーションと人数計算で、判定方法と必要人数の関係を考えます。
無作為化しても判定を誤る理由
A/Bテストでは利用者を無作為に2群へ割り付け、A群には変更前のページ、B群には変更後のページを表示します。購入意欲などの偏りを抑え、両群の購入率の差から変更の効果を推定する設計です。ただし、無作為に分けても購入者数は毎回変わります。推定した差がどの程度ばらつくかを表すのが信頼区間です。
割付単位と購入率の分母を利用者にそろえ、再訪時も同じ群を表示する設計です。購入率は、事前に定めた追跡期間内に購入した利用者数を、割り付けた利用者数で割った値です。再訪で分母を増やしたり、表示に失敗した人を分母から外したりすると、比較する対象が変わってしまいます。
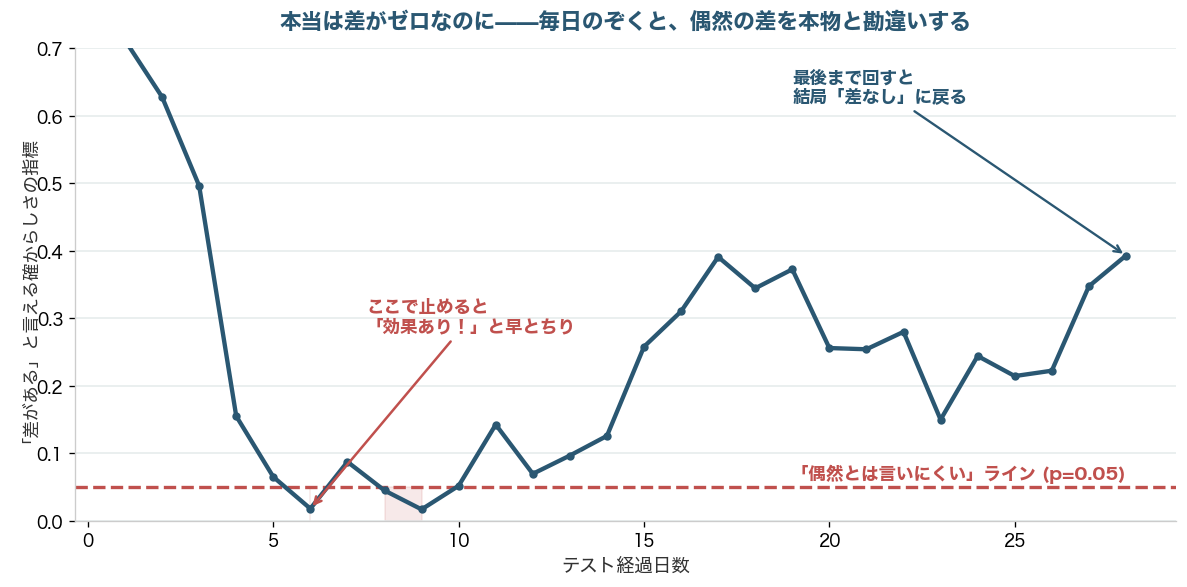
有意になった日に止めると誤判定が増えます
途中停止の影響を見るため、A群とB群の真の購入率を同じに置きます。この設定なら、改善・悪化のどちらに「差あり」と判定しても誤判定です。
p値は、両群の真の購入率が同じだと仮定したとき、検定の前提のもとで観測結果と同程度以上に極端な結果が出る確率です。両側検定では改善・悪化の両方向を扱い、事前に決めた有意水準0.05を下回れば有意と判定します。「効果がある確率が95%」という意味ではありません。米国統計学会の2016年の声明も、p値のこの解釈を戒めています。
最終日までのp値の推移を使って、二つの判定方法を比べた例です。途中でp値が有意水準0.05を下回り、終了時点では上回っています。途中の有意差で止めれば「差あり」、予定どおり最後に判定すれば「有意差なし」と、同じ試行でも結論が変わります。
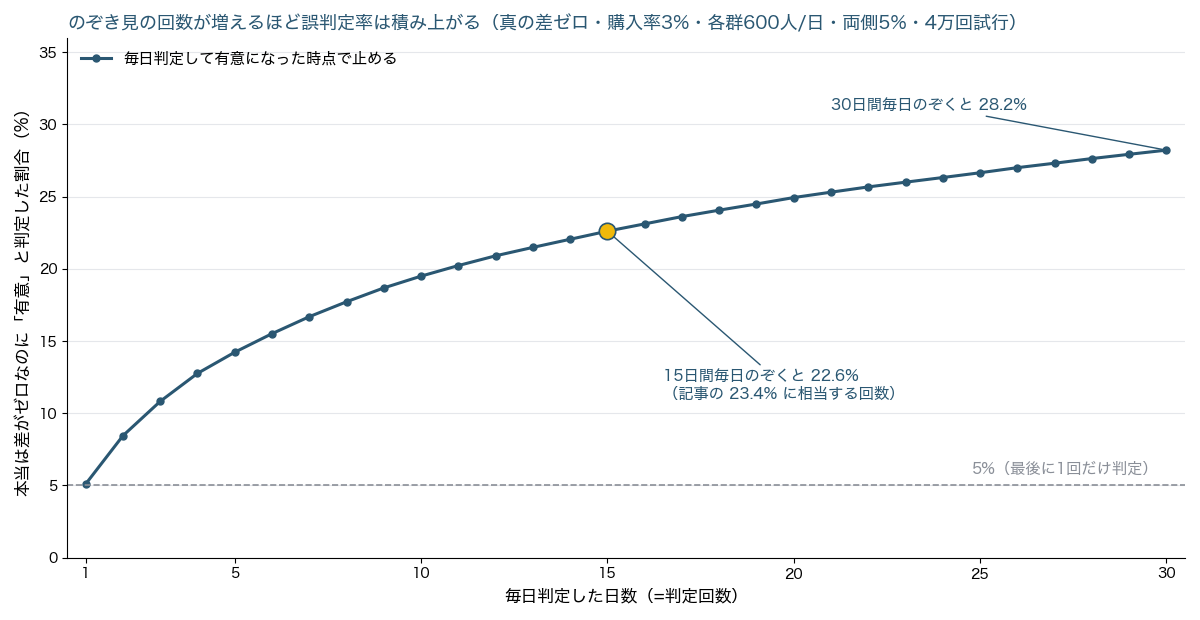
この計算での誤判定率は、7日間で約16%、30日間で約28%でした。両群の購入率3%、各群600人/日、累積データへの両側プールz検定、有意水準5%で、1日目から毎日判定し、初めて有意になった時点で打ち切る条件です。
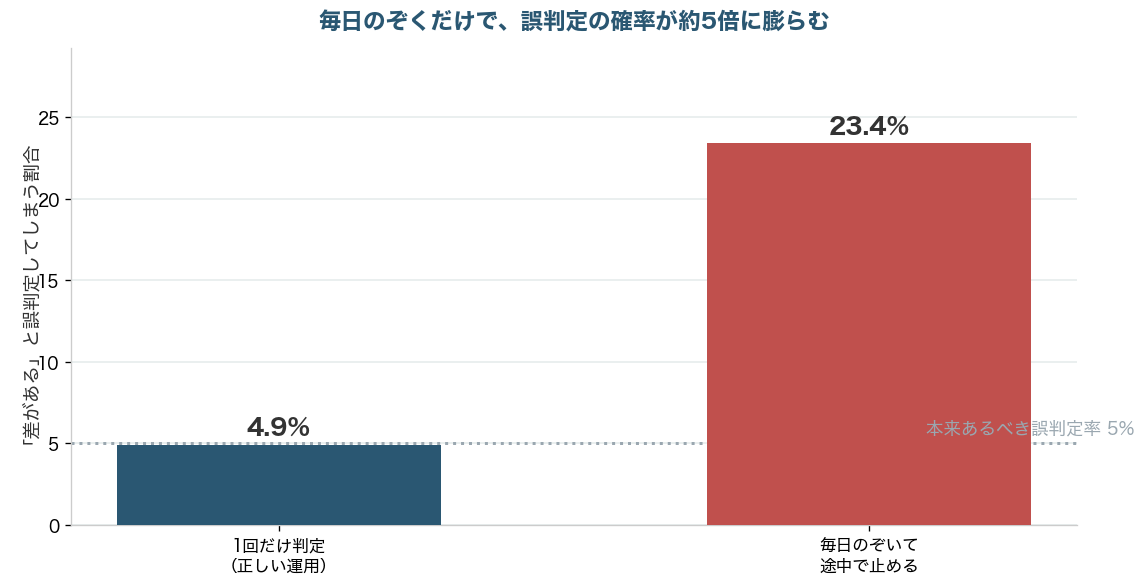
棒グラフの4.9%と23.4%は、終了時だけの判定と日次の途中停止を比べる目安です。この計算では、購入率3%・各群600人/日・両側有意水準5%で、30日目だけの判定が4.89%、日次判定での途中停止が15日で22.6%、17日で23.6%でした。
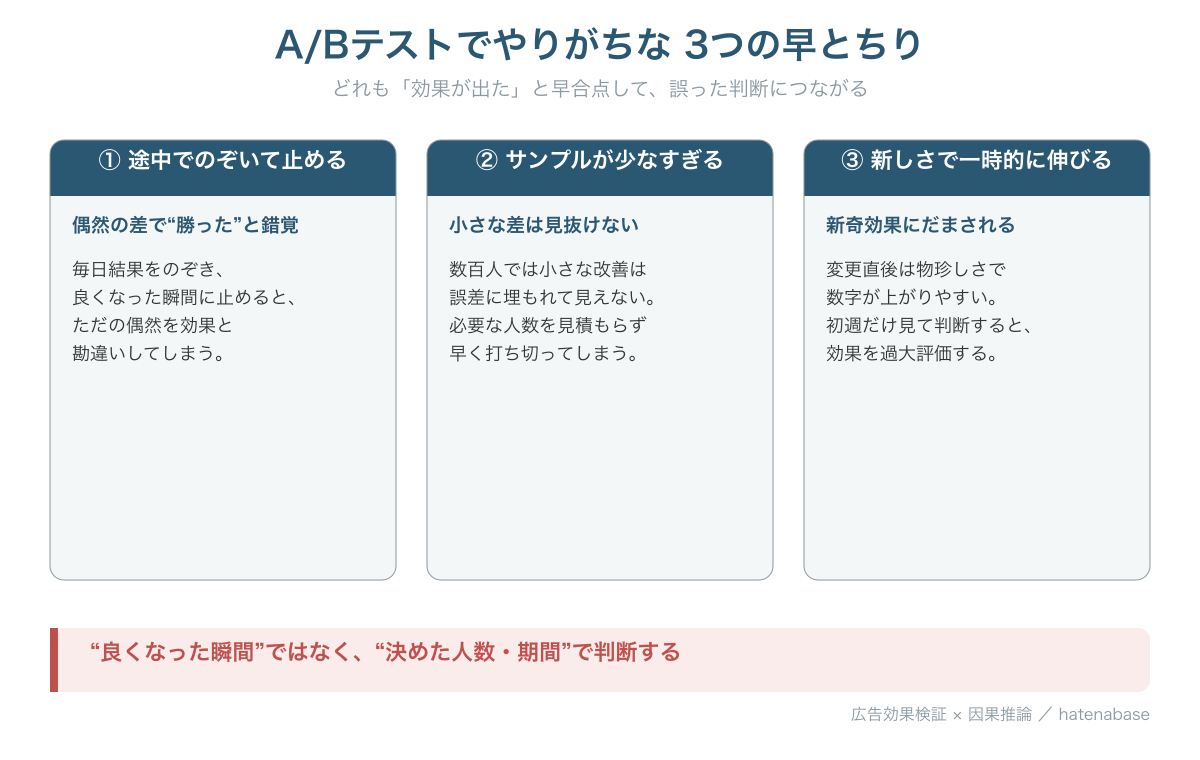
Evan Millerは「How Not To Run An A/B Test」で、結果に応じた途中停止を問題にしています。累積データによる判定は互いに依存していても、判定機会を増やすほど、一度でも有意になる確率は上がります。
停止時の改善幅も過大になりやすくなります。有意な改善が出た日に止めるのは、偶然大きく出た差を選ぶことだからです。
小さな改善の検出には多くの人数が必要です
人数計算では、基準購入率3%、独立した2群への均等割付、両側有意水準5%、検出力80%を使います。二比率の正規近似による再計算値は、相対5%・10%・30%改善の順に各群207,938人・53,211人・6,455人で、端数を切り上げています。
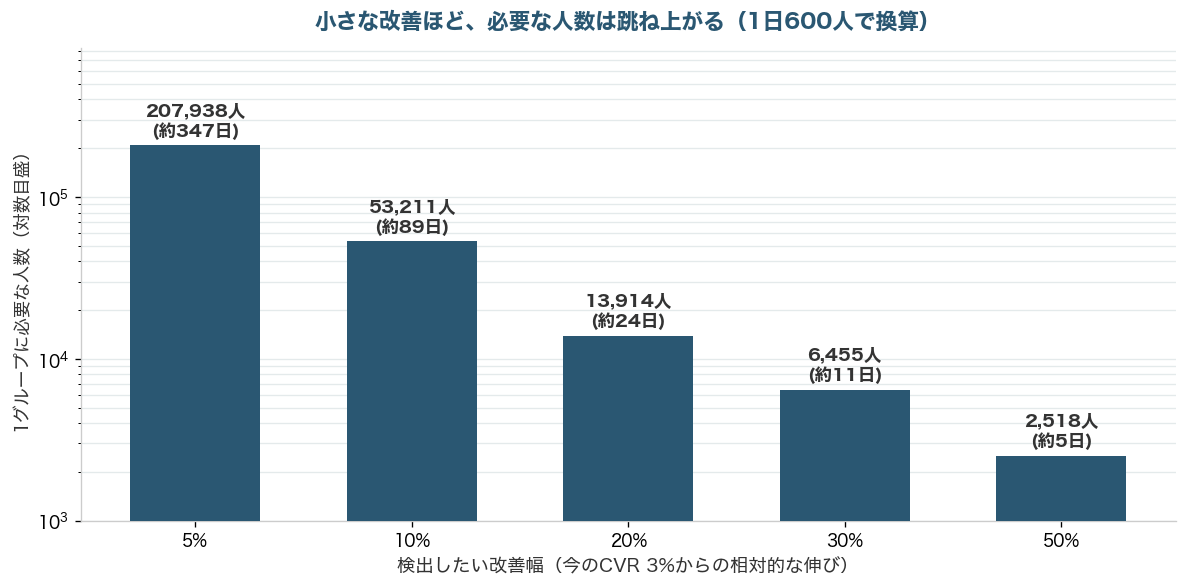
購入率3%から3.15%への変化は、相対5%、絶対差では0.15パーセントポイントの改善です。必要な各群約21万人を1日600人ずつ集めるなら約350日、サイト全体で1日600人を半分ずつ割り付けるなら約700日かかります。これは新たに実験へ入る利用者を集める日数で、最後に入った人の購入を追跡する期間は別です。同じ条件でも、相対10%改善なら各群約5万3千人、相対30%改善なら約6,500人となります。
アクセスが限られるECでは、先に実施可能な人数と期間から測れる改善幅を逆算します。送料無料ラインや商品ページの構成を変える案は、その後で検討します。
クリック率や利用者インタビューは、次に試す案を絞る材料に使います。購入率を測るには人数が足りないからと、クリック率の改善を採用理由にすると、答える問いが変わってしまいます。
最小検出効果は、人数設計で置く改善幅です。採否を決める際には、得られた改善幅と導入・運用の費用を比べます。統計的に検出できる差が、そのまま費用を回収できる差になるとは限りません。
初週の伸びと継続効果を分けて読む
リピーターが新しいバナーに反応し、一時的にクリックや購入が増えるのが新奇効果です。
新奇効果を単純化し、基準購入率3%、各群600人/日で、実験開始後の初週だけ相対30%改善し、以後は差がゼロになる例を考えます。
B群の購入率を1〜7日目は3.9%、8〜30日目は3%としたこの計算では、30日目の両側有意水準5%の検定で有意になった試行の割合は約21.5%でした。各日同人数なのでB群の30日平均購入率は3.21%となり、A群との差は実在します。この全期間の平均差を、8日目以降も続く効果とは解釈できません。
週ごとの購入率差と信頼区間を並べます。全期間の平均に埋もれた変化を読むためです。実サイトで利用者の慣れを調べる際は、実験開始からの日数に加え、初回接触からの経過日数も分析計画に入れます。新規・既存の区分は施策前の履歴で決め、再訪した人だけを後から選ぶ集計は避けます。
人数・期間・終了条件を事前に決める
途中で採否を決める運用なら、判定時点ごとに許容する誤判定確率を配分する群逐次法を候補にします。以下は、固定期間方式での運用です。
- 募集期間と最低人数を先に決めます。募集期間の終了時に人数が集まっていなくても募集を終えます。途中の効果を理由に延長する運用は選びません。
- 期間中の監視対象は割付と計測です。割付人数が予定の比率から外れていないかをカイ二乗検定などで調べるSRMチェックと、購入イベントの重複・欠測の点検を組み込みます。障害で中止した場合は、中止理由と集計可能な範囲を残します。
- 曜日構成と再訪・購入の周期から観測期間を決めます。人数が先に集まっても予定した募集期間は守り、集計は最後に入った利用者の追跡完了後です。
- 判定は最後に1回です。事前に決めた主要指標で購入率差と信頼区間を求めます。人数未達で終えた実験も、その人数で得られた推定の幅を報告します。
信頼区間の上限が費用回収に必要な改善幅を下回れば、採用を見送ります。一方、区間がその改善幅をまたぐ場合、この結果だけでは採算を判断できません。結果には採否の理由を添えます。
計算の自動化にも設計条件を引き継ぐ
自動化フローに割付単位、購入の追跡期間、検定方法、停止条件を設定として持たせます。AIの利用手順は「AIを入れる」から「安全に回す」へにまとめています。
無作為化できない場合の比較方法
無作為に割り付けられない施策では、差分の差分法を扱う実践編や、合成コントロール法を扱う発展編の比較設計が候補です。前者では施策がない場合の両群の推移、後者では施策前の適合と比較対象への影響が、手法を選ぶ判断材料になります。
A/Bテストの運用判断チェック
- 問1
購入ボタンの色を変えるA/Bテストで、3日目には新色Bの購入率が旧色Aを上回っていました。固定期間の検定を使う場合、この結果をどう扱いますか?
解説固定期間の検定では、途中の購入率を理由に終了条件を変えません。差が大きく出た日を選んで止めると、偶然の改善を拾いやすくなります。 - 問2
購入率3%から3.15%への相対5%改善を検出するA/Bテストを企画しています。独立した2群への均等割付、両側有意水準5%、検出力80%とし、各群に1日600人ずつ新たに割り付けられます。開始前にどう計画しますか?
解説人数を集めるだけで長期間かかる計画です。実施可能な期間から測れる改善幅を逆算し、その差を検証する価値があるかを考えます。 - 問3
トップページの新しいバナーをA/Bテストしたところ、初週のクリック率が大幅に伸びました。継続的な効果として全利用者への導入を決められますか?
解説全期間の平均には初週の伸びが残るので、週別の差も判断材料にします。選択肢3では、結果を見て流入を変えることで評価対象の利用者構成も変わります。選択肢4は、有意な週を選ぶ途中停止です。 - 問4
「A/BテストをAIで自動運用し、有意になった時点で勝者を採用したい」と提案されました。停止条件をどう設計しますか?
解説自動化フローにも、固定期間での最終判定か、逐次法に対応する停止規則を組み込みます。通常のp値の閾値を下げるだけでは、結果に応じて止める問題は解消しません。
はてなベースが、効果検証に必要なデータ整備と比較方法の設計を支援します
効果検証の前に、利用者ID、割付履歴、購入イベントを結び付け、何と何を比べるかを決めます。計測漏れや比較対象の不備があると、分析手法が適切でも結論を誤ることがあります。はてなベースでは、こうしたデータ整備と比較方法の設計を支援しています。
そのA/Bテスト、正しく回せていますか 散在するデータを集約し、分析に使える形に整理するデータ基盤の整備、効果検証や仮説設計を支援する分析・AI活用の支援、そして「全社で安全にAIを使いたい」という方へのオンプレミスAI(自社で管理するサーバーなどで動かすAI)導入支援まで、貴社の状況に合わせて支援します。A/Bテストの設計やデータ整備について、無料相談を受け付けています。 無料相談はこちら
参考文献
- [1]How Not To Run An A/B Test(のぞき見問題の古典的解説)Evan Miller
- [2]広告効果測定の最新事情 差分の差分法野村総合研究所(NRI)