2026 年 11 月 13 日から 14 日にかけて Microsoft 365 のメールが世界中で止まった障害について、Microsoft が原因を公表しました。7 月に入れた修正に不具合があり、3 か月以上だれにも気づかれないまま世界中のサーバーで動いていました。その不具合が、障害の当日にほかの 2 つの条件と重なって表に出ました。
Microsoft は日本時間 11 月 17 日の未明に暫定の事後報告書を管理センターで公開し、同社の幹部チャールズ・ラマナ氏が X に要約を投稿しました。この記事は、11 月 14 日に公開したまとめ記事の続報です。ラマナ氏の投稿をもとに、原因と、自社のシステム運用に引き寄せて確かめたい点を整理します。
障害は3つの要因が重なって起きた
止まったのは、Microsoft 365 の多くのサービスの手前で通信を受け付ける「ネットワークゲートウェイ」と呼ばれるサーバー群です。ラマナ氏は、次の 3 つが重なったと説明しています。
| 要因 | いつ | 何が起きていたか |
|---|---|---|
| 眠っていた不具合 | 7 月から | ゲートウェイ用の修正に不具合があり、特定の負荷がかかるとサーバーが応答しなくなる状態だった |
| 通信の集中 | 障害の約 15 時間前 | Teams の通信が、もう一方の系統から、メールと共用の系統へ切り替わった |
| 余力の減少 | 障害の前日から | 別の問題で、ゲートウェイのサーバーの約 14% が止まっていた |
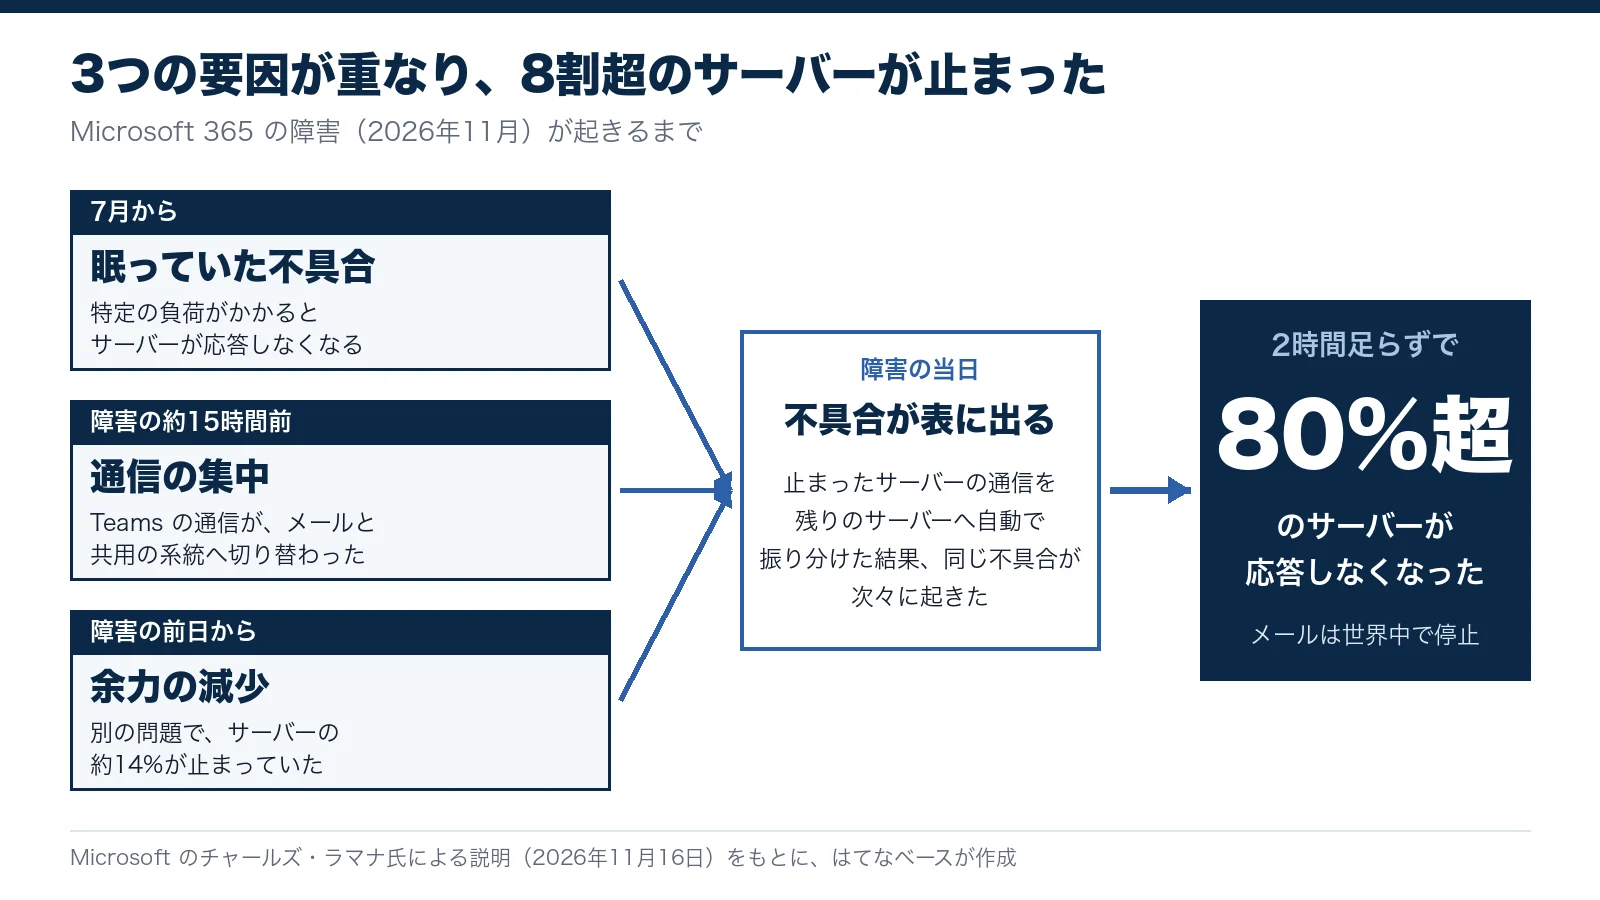
2 つ目の切り替えは、Microsoft が障害に備えてふだんから行っている通常の運用です。3 つ目も、余力が十分にあったため単独では影響がありませんでした。どちらも単独なら問題にならない出来事でした。
不具合が 3 か月以上見つからなかった理由も説明されています。この不具合は、CPU のコア数が多い新しい機種ほど起きやすいものでした。一方、Microsoft の負荷試験はコア数の少ない古い機種を中心に行われていました。
2時間足らずで8割超のサーバーが止まった
サーバーが 1 台止まると、Microsoft の仕組みは利用者の通信をほかの正常なサーバーへ自動で振り分けます。ふだんは障害を防ぐための仕組みです。今回は、振り分けられた通信が残りのサーバーの負荷を上げ、同じ不具合を次々に引き起こしました。
ラマナ氏は「At its lowest, more than 80% of servers were unresponsive.」と書いています。最も悪い時点で、8 割を超えるサーバーが応答しなくなったという意味です。そこに至るまでは 2 時間足らずでした。
ゲートウェイは本来、数千の区画に分かれており、ある区画の障害がほかへ広がらない作りになっています。今回は別の問題のために区画の仕切りが働かず、障害が世界中に広がりました。この「別の問題」の中身は、今回の説明には書かれていません。
メールだけ復旧が遅れた理由
Teams、OneDrive、SharePoint、Office アプリは、止まった系統からもう一方の系統へ移れました。Teams のチャットと会議が大部分使えたのはこのためです。Exchange Online(Outlook のメール)は、この系統から移れない作りでした。
復旧に時間がかかった理由は 2 つあります。
- サーバーを再起動しても、待っていた通信が一気に流れ込み、すぐにまた応答しなくなった
- 不具合の元が数か月前の変更だったため、直前の変更を取り消すいつもの方法では戻せなかった
Microsoft は、問題の処理を以前の正常な状態に戻す更新を新しく作りました。そのうえで、サーバーをまとまった単位(地域の半分以上など)でいったん外し、更新を当てて再起動してから戻す作業を繰り返しました。
11 月 14 日の時点で Microsoft は「以前のネットワーク容量の増強作業で生じた問題が、最近のネットワーク変更で表に出た」とだけ説明していました。今回の説明で、「以前の作業」が 7 月の修正、「最近の変更」が Teams の通信の切り替えと余力の減少を指していたことが分かりました。
自社のシステム運用で確かめたい3つのこと
世界最大級のクラウドでも、試験を通った変更が 3 か月後に障害を起こしました。規模は違っても、社内で kintone やクラウド会計、自社開発のシステムを運用している会社に当てはまる点があります。
| 確かめること | 今回の障害で起きたこと |
|---|---|
| 試験の環境は本番と同じ条件か | 試験は古い機種が中心で、新しい機種で起きる不具合を見逃した |
| 余力が減っている日に、切り替えや更新を重ねていないか | 単独では無害な 2 つの出来事が同じ日に重なった |
| 「直前の変更を取り消す」以外の復旧手順があるか | 原因が数か月前の変更だったため、取り消しでは戻せなかった |
1 つ目は、データの量にも当てはまります。数百件の試験データでは速く動いた集計や連携が、本番の数万件では止まることがあります。
Microsoft は、最終版の事後報告書を今週中に出すとしています。再発防止策や、区画の仕切りが働かなかった理由が示されたら、この記事に追記します。
クラウドとシステムの運用の備えをご相談ください
どの業務がどのクラウドサービスに頼っているかの洗い出しから、更新や切り替えの手順、止まったときの復旧手順づくりまでご支援しています。